模型评估
一、模型评估概述
1.什么是模型评估
模型评估是指在机器学习和数据挖掘等领域,对已经训练好的模型的性能进行量化分析和评价的过程。它的目的是为了了解模型的质量、准确性、可靠性等多个方面的性能,从而判断模型是否能够有效地解决实际问题,并且为模型的选择、优化和改进提供依据。
2.模型评估类型
模型评估按任务主要分为回归任务评估(如均方误差、平均绝对误差、决定系数等指标)、分类任务评估(如准确率、精确率、召回率、F1 - score、AUC - ROC、PR 曲线等指标)和聚类任务评估(如轮廓系数、戴维森堡丁指数等指标)。
3.模型泛化能力
模型泛化能力是指机器学习模型对新数据(即未在训练过程中使用过的数据)进行准确预测或分类的能力。简单来说,一个具有良好泛化能力的模型能够从训练数据中学习到数据的内在规律和模式,并且可以将这些知识应用到新的、未知的数据上,从而产生合理、准确的输出。
4.过拟合、欠拟合
过拟合与欠拟合是机器学习中常见的两个概念,描述的是模型在训练数据和未知数据上表现的差异。下图中第一到第三的图分别是欠拟合、正好和过拟合三种状态。

4.1过拟合
定义:过拟合是指机器学习模型在训练数据上表现得非常好,但在新的数据(测试数据或实际应用中的数据)上表现很差的现象。
缓解方法:
- 增加训练数据量(更多的训练数据可以让模型学习到更全面、更具代表性的数据模式,减少对训练数据中个别特殊模式的过度关注。)
- 正则化方法
- Dropout(要用于神经网络主)
- 简化模型结构(如果模型过于复杂,就容易产生过拟合。通过减少模型的参数数量或者层数(在神经网络中)等方式来降低模型的复杂度。)
- 早停止(Early Stopping)
4.2欠拟合
定义:欠拟合是指机器学习模型没有充分学习到训练数据中的规律和特征,导致在训练数据和新的数据(测试数据或实际应用中的数据)上都表现不佳的情况。
缓解方法:
- 增加模型复杂度(对于过于简单的模型,通过增加其复杂度可以使其更好地拟合数据中的复杂规律。)
- 延长训练时间或调整训练参数
- 更换模型类型
二、常见的模型评估分类
1.混淆矩阵
混淆矩阵(Confusion Matrix)是机器学习和统计分类中用于评估分类模型性能的一个表格。它展示了分类模型的预测结果与实际结果之间的对比情况,通常用于监督学习中的分类任务,如二分类(如判断邮件是垃圾邮件还是非垃圾邮件)和多分类(如识别图像中的物体是猫、狗还是其他动物)问题。
| 混淆矩阵 | 预测结果 | ||
|---|---|---|---|
| 正例 | 反例 | ||
| 真实情况 | 正例 | TP(真正例) | FN(假反例) |
| 反例 | FP(假正例) | TN(真反例) | |
- 在多分类问题中,混淆矩阵是m×n的矩阵(n是类别数)。可以通过查看对角线上的元素(即TP值)来初步判断模型好坏。
- 例如,在一个对 10 种花卉进行分类的任务中,混淆矩阵对角线上的元素之和占总样本数的比例较高,说明模型对各个类别正确分类的能力较强。
2.准确率(Accuracy)
- 描述:所有分类正确的样本数占总样本数的比例。
- 公式:Accuracy = (TP+TN)/(TP+FN+FP+TN)
3.精确率(Precision)
- 描述:正确预测为正的样本数(True Positives,TP)与所有预测为正的样本数(即True Positives +False Positive)之比。
- 公式:Precision=TP/(TP + FP)
4.召回率(Recall)
- 描述:正确预测为正的样本数(True Positives,TP)与所有实际为正的样本数(即True Positives +False Negatives)之比。
- 公式:Recall = TP/(TP+FN)
5.PR曲线(Precision - Recall Curve)
- 描述:在各种阈值设置下,精确率(Precision)和召回率(Recall)的曲线。也是通过描绘两个指标之间的关系来展示分类器性能。
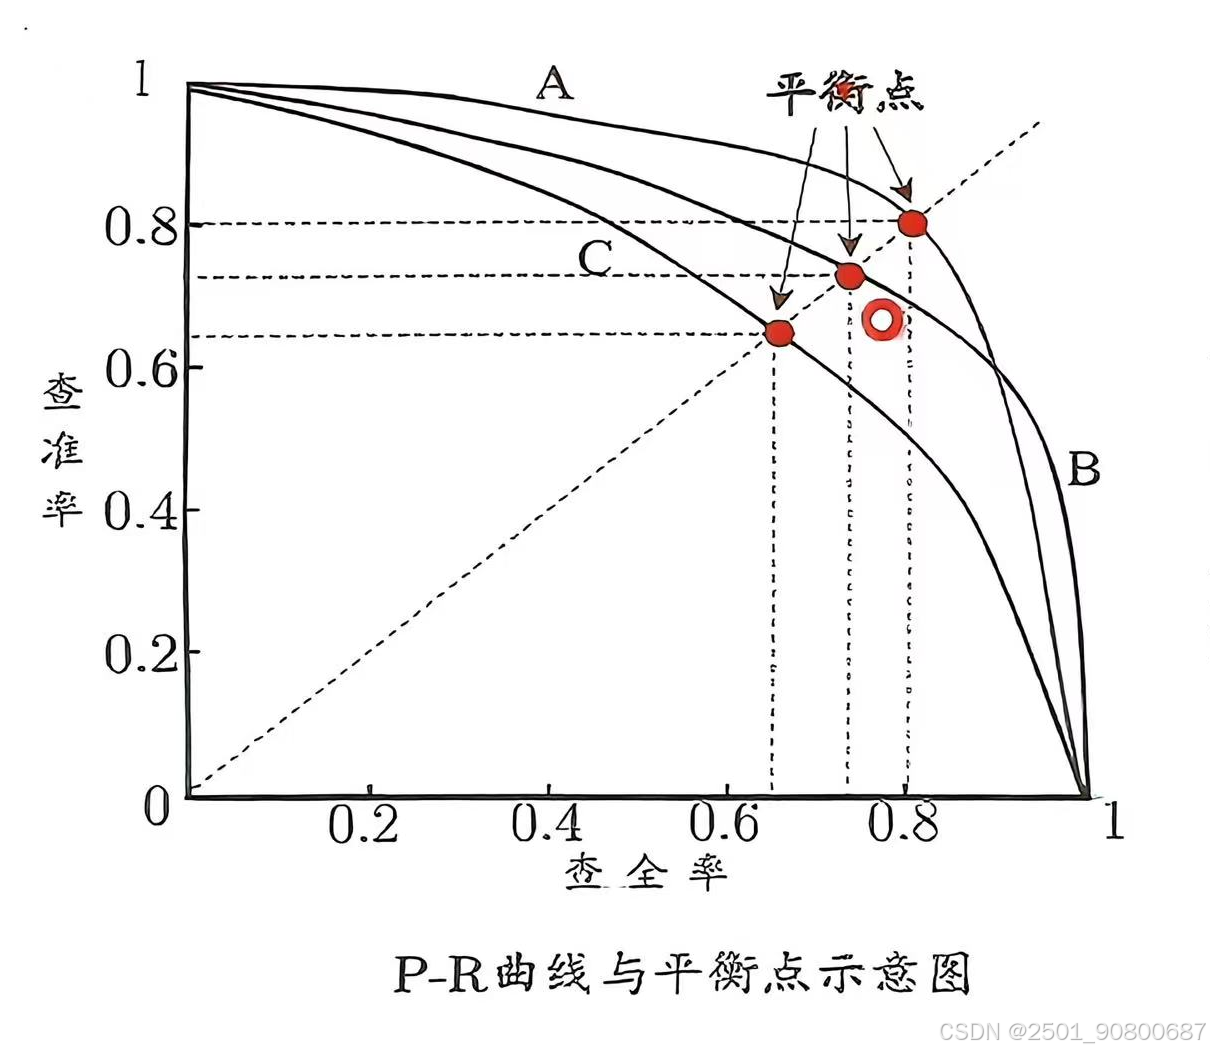
平衡点是曲线上“查准率=查全率”时的取值,可以用来度量P-R曲线有交叉的分类器性能高低。
6.F1分数(F1 Score)
- 描述:精确率和召回率的调和平均值。F1的大小反映了模型的稳定性,数值越大说明越稳定。
- 公式:F1=2×Precision×Recall / (Precision + Recall)

7.ROC曲线(Receiver Operating Characteristic Curve)
- 描述:在各种阈值(阈值不同,生成的混淆矩阵也不同,TPR、FPR的值也不同)设置下,真正例率(TPR)对假正例率(FPR)的曲线。通过描绘两个指标之间的关系来展示分类器性能。

ROC曲线越偏左上角(曲线没有交叉时)效果越好,低于平衡线几乎没有存在必要。
8. AUC (Area Under the ROC Curve)
- 描述:ROC曲线下的面积,是用于评估分类器在不同决策边界的情况下的整体性能的指标。
- 特点:AUC的值介于0和1之向。一个完美的分类器的AUC值为1,而一个随机猜测的分类器的AUC值为0.5。
- 优点:AUC考虑了所有可能的决策边界,因此它为比较不同模型的性能提供了一神不依赖于特定阈值的方法。

AUC(即ROC曲线与横坐标围成的面积)越大(曲线相交时),学习器性能越好。
9.AP(Average Precision)
- 描述:PR曲线下的面积,用于评估分类器的整体精确率。
- 特点:AP的值介于0和1之间,完美分类器的AP值为1,随机分类器的AP值等于数据中正类的比例。
- 优点:与AUC类似,AP为分类器提供了一个整体的性能度量,不依赖于特定的阈值。但是,与AUC不同,AP特别适用于正负样本不平衡的情况。
三、ROC曲线与PR曲线的差异
1、曲线特点
1.1 ROC 曲线
- 理想情况下,ROC 曲线会经过点 (0, 0) 和 (1, 1),且越靠近左上角,说明模型性能越好。
- 随机分类器的 ROC 曲线是一条从 (0, 0) 到 (1, 1) 的对角线。
- ROC 曲线对正负样本的分布相对不敏感,因为 FPR 和 TPR 的计算都基于各自类别的总数。
1.2 PR 曲线
- 理想情况下,PR 曲线会尽可能地靠近右上角,即精确率和召回率都很高。
- 随机分类器的 PR 曲线会接近一条水平直线,因为其精确率和召回率都较低且相对稳定。
- PR 曲线对正负样本的分布非常敏感,在类别不平衡的数据集上表现差异较大。
2、适用场景
2.1 ROC 曲线
- 当正负样本比例相对均衡时,ROC 曲线能很好地评估模型性能。
- 在一些需要综合考虑模型对正例和负例识别能力的场景中,如疾病筛查的初步评估,ROC 曲线很有用。
2.2 PR 曲线
- 对于类别不平衡的数据集,PR 曲线更能反映模型在正例上的表现。例如在欺诈检测中,欺诈样本通常是少数类(正例),PR 曲线可以更好地展示模型对欺诈样本的识别能力。
- 在对精确率和召回率有明确要求的应用中,如信息检索领域,用户更关注检索结果中相关文档的比例(精确率)以及是否遗漏了相关文档(召回率),此时 PR 曲线更适用。
3、评估指标
3.1 ROC 曲线
- 常用的评估指标是曲线下面积(AUC - ROC)。AUC - ROC 的值介于 0 和 1 之间,值越大表示模型性能越好。AUC = 0.5 时表示模型效果等同于随机分类。
- AUC - ROC 综合考虑了模型在所有阈值下的表现。
3.2 PR 曲线
- 评估指标是曲线下面积(AUC - PR)。同样,AUC - PR 越大,模型性能越好。
- 有时也会关注特定召回率下的精确率,或者在一定精确率要求下的召回率。
总之,ROC 曲线和 PR 曲线各有特点和适用场景,在评估机器学习模型时,应根据具体问题和数据特点选择合适的曲线来进行分析。
下面将根据k邻近算法绘制如下ROC曲线和PR曲线:


ROC 曲线(第一张图)
- 表现:曲线靠近左上角,AUC 达 0.98,说明模型区分正例和负例能力强,能在低误判率下识别大量正例。
- 适用场景:适合综合考量对正例和负例识别能力的场景,如疾病初步筛查。
PR 曲线(第二张图)
- 表现:低召回率时精确率高,召回率增加时精确率迅速下降,说明模型初始识别正例准确性高,但全面覆盖正例时准确性受影响。
- 适用场景:在对精确率要求高的场景(如信息检索前期)表现尚可,但要全面召回正例时效果欠佳。
总之,该模型有优势也有局限,实际应用需依对精确率和召回率的侧重选择。
四、代码具体实现
跟军knn的约会网站绘制ROC曲线和PR曲线代码如下:
import numpy as np
import operator
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_curve, auc, precision_recall_curve
import matplotlib.pyplot as plt


def classify0(inX, dataSet, labels, k):
    dataSetSize = dataSet.shape[0]
    diffMat = np.tile(inX, (dataSetSize, 1)) - dataSet
    sqDiffMat = diffMat ** 2
    sqDistances = sqDiffMat.sum(axis=1)
    distances = sqDistances ** 0.5
    sortedDistIndices = distances.argsort()
    classCount = {}
    for i in range(k):
        voteIlabel = labels[sortedDistIndices[i]]
        classCount[voteIlabel] = classCount.get(voteIlabel, 0) + 1
    sortedClassCount = sorted(classCount.items(), key=operator.itemgetter(1), reverse=True)
    return sortedClassCount[0][0]


def file2matrix(filename):
    fr = open(filename)
    arrayOLines = fr.readlines()
    numberOfLines = len(arrayOLines)
    returnMat = np.zeros((numberOfLines, 3))
    classLabelVector = []
    index = 0
    for line in arrayOLines:
        line = line.strip()
        listFromLine = line.split('\t')
        returnMat[index, :] = listFromLine[0:3]
        if listFromLine[-1] == 'didntLike':
            classLabelVector.append(1)
        elif listFromLine[-1] == 'smallDoses':
            classLabelVector.append(2)
        elif listFromLine[-1] == 'largeDoses':
            classLabelVector.append(3)
        index += 1
    return returnMat, classLabelVector


def autoNorm(dataSet):
    minVals = dataSet.min(0)
    maxVals = dataSet.max(0)
    ranges = maxVals - minVals
    normDataSet = np.zeros(np.shape(dataSet))
    m = dataSet.shape[0]
    normDataSet = dataSet - np.tile(minVals, (m, 1))
    normDataSet = normDataSet / np.tile(ranges, (m, 1))
    return normDataSet, ranges, minVals


def predict_proba(inX, dataSet, labels, k):
    dataSetSize = dataSet.shape[0]
    diffMat = np.tile(inX, (dataSetSize, 1)) - dataSet
    sqDiffMat = diffMat ** 2
    sqDistances = sqDiffMat.sum(axis=1)
    distances = sqDistances ** 0.5
    sortedDistIndices = distances.argsort()
    classCount = {}
    for i in range(k):
        voteIlabel = labels[sortedDistIndices[i]]
        classCount[voteIlabel] = classCount.get(voteIlabel, 0) + 1
    total = sum(classCount.values())
    probs = []
    for label in sorted(set(labels)):
        probs.append(classCount.get(label, 0) / total)
    return np.array(probs)


if __name__ == '__main__':
    filename = "datingTestSet.txt"
    datingDataMat, datingLabels = file2matrix(filename)
    normMat, ranges, minVals = autoNorm(datingDataMat)
    X_train, X_test, y_train, y_test = train_test_split(normMat, datingLabels, test_size=0.3, random_state=42)
    k = 3
    y_score = []
    for test_sample in X_test:
        probs = predict_proba(test_sample, X_train, y_train, k)
        y_score.append(probs[1])  # 假设关注类别2的概率
    y_score = np.array(y_score)
    y_test_binary = np.array(y_test) == 2

    # 计算ROC曲线
    fpr, tpr, thresholds = roc_curve(y_test_binary, y_score)
    roc_auc = auc(fpr, tpr)

    # 绘制ROC曲线
    plt.figure()
    plt.plot(fpr, tpr, color='darkorange', lw=2, label='ROC curve (area = %0.2f)' % roc_auc)
    plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--')
    plt.xlim([0.0, 1.0])
    plt.ylim([0.0, 1.05])
    plt.xlabel('False Positive Rate')
    plt.ylabel('True Positive Rate')
    plt.title('Receiver operating characteristic example')
    plt.legend(loc="lower right")
    plt.show()

    # 计算PR曲线
    precision, recall, _ = precision_recall_curve(y_test_binary, y_score)

    # 绘制PR曲线
    plt.figure()
    plt.plot(recall, precision, color='blue', lw=2, label='PR curve')
    plt.xlim([0.0, 1.0])
    plt.ylim([0.0, 1.05])
    plt.xlabel('Recall')
    plt.ylabel('Precision')
    plt.title('Precision - Recall curve')
    plt.legend(loc="lower left")
    plt.show()
运行结果为上面的两张图。
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)