Batch Normalization和Layer Normalization的区别(一)
笔者在学习Vision Transformer模型时,注意到Transformer Encoder模块中,在进行多头注意力机制(Multi-Head Attention)和前馈神经网络层(MLP)之前都会进行Layer Normalization。想到之前在学习其他模型时用到的Batch Normalization,于是提出疑问:二者的主要区别以及适用情况是什么?特整理出该文进行系统地学习。
本篇主要讲解Batch Normalization(批量归一化):
1.1 Batch Normalization的原理
1.2 Batch Normalization的具体操作
1.3 动量(Momentum)方法
1.4 使用pytorch进行验证
1.5 使用BN时的注意事项
1.6 BN的优点和缺点
参考:太阳花的小绿豆:Batch Normalization详解以及pytorch实验
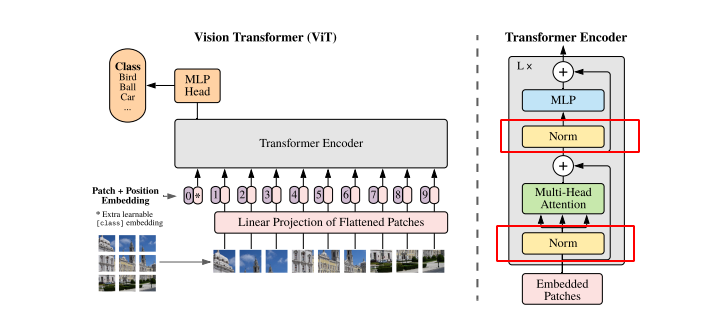
一、Batch Normalization:批量归一化
1.1 Batch Normalization的原理
在深度神经网络的训练过程中,随着网络层数的增加,梯度传播可能会变得不稳定,导致训练过程难以收敛。具体来说,每一层的输入分布会随着训练的进行而发生变化,这种现象被称为“内部协变量偏移”(Internal Covariate Shift)。内部协变量偏移会导致网络训练速度变慢,因为每一层的输入分布变化使得网络需要不断调整参数来适应新的输入分布。
想象一下,你在搭积木,每一块积木都有自己的大小和形状。如果你每次搭积木的时候,积木的大小和形状都在变,那你肯定很难把积木搭得又稳又高。在神经网络里也是一样的,每一层的输入数据就像是这些积木,如果它们的“大小和形状”(也就是数据的分布)一直在变,网络就很难稳定地学习,训练速度也会很慢。这种数据分布变化的问题,就叫“内部协变量偏移”。
Batch Normalization的核心思想是对每一层的输入进行归一化处理,使得每一层的输入分布保持相对稳定,从而减少内部协变量偏移。具体来说,它通过以下步骤实现:
-
对每个小批量(Batch)数据的输入进行归一化,使其均值为0,方差为1。
-
通过引入两个可学习的参数(缩放参数γ和偏移参数β),对归一化后的数据进行缩放和偏移,以恢复网络的表达能力。
1.2 Batch Normalization的具体操作
以下标黄部分是从原论文中截取的原话:“对于一个拥有d维的输入x,我们将对它的每一个维度进行标准化处理。”
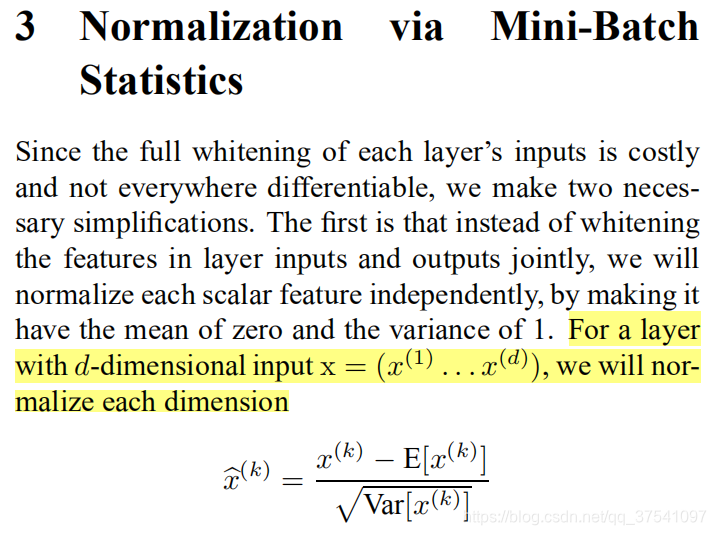
假设我们有一张彩色图片,它有三个通道:红色(R)、绿色(G)和蓝色(B),所以这里的d就是3。我们把这三个通道分别记为 (红色通道)、
(绿色通道)和
(蓝色通道),也就是
,其中
代表R通道所对应的特征矩阵。每个通道都是一个矩阵,矩阵里的每个元素是一个像素值。标准化处理也就是分别对R通道,G通道,B通道进行处理,而不是把三个通道混在一起处理。原文提供了更加详细的计算公式:
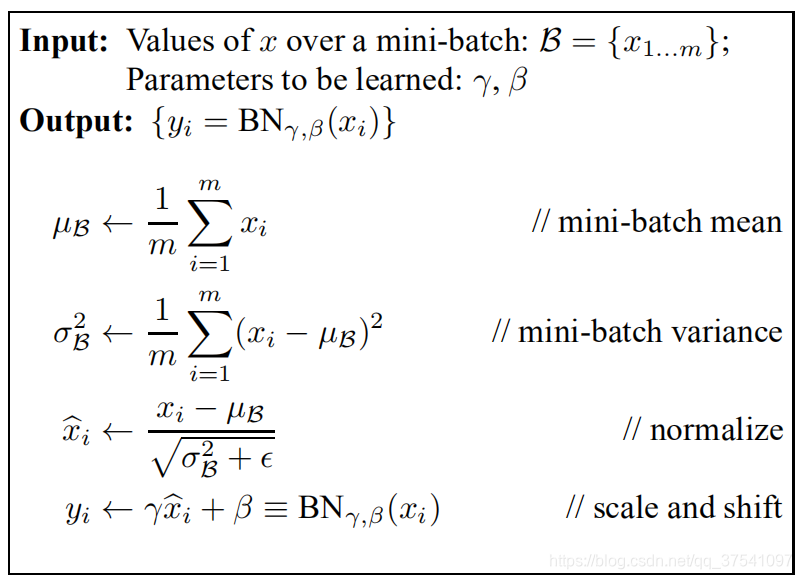
在上文提到:Batch Normalization的核心思想是对每一层的输入进行归一化处理,使得每一层的输入分布保持相对稳定,从而减少内部协变量偏移。理论上,我们希望用整个训练样本的所有特征图(feature map)来计算每个通道的平均值和方差,然后用这些平均值和方差来标准化每个通道的特征。这样,每个通道的特征值都会变得很整齐,分布规律也会很统一。但是,这个想法在现实中很难实现,因为数据集太大了,计算整个数据集的平均值和方差会非常耗时。
为了解决这个问题,Batch Normalization提出了一个折中的办法。它不是用整个数据集来计算平均值和方差,而是用一个小批量(Batch)的数据来计算。每次训练的时候,我们只取一小部分数据集,然后用这些小部分数据集来计算每个通道的平均值和方差。虽然这个小批量的数据只是整个数据集的一部分,但它可以近似整个数据集的分布规律。而且,小批量越大,这个近似就越准确。
根据上图的公式可以知道,代表着feature map中每个维度(channel)的均值,注意它是一个向量,而不是一个值,向量的每一个元素代表着每一个维度(channel)的均值。
代表着feature map每个维度(channel)的方差,注意它也是一个向量不是一个值,向量的每一个元素代表着每一个维度(channel)的方差,然后计算标准化处理后得到的值。下图给出了一个计算均值和方差的示例:

这张图展示了Batch Normalization(BN)在处理两个特征矩阵(feature1和feature2)时的具体计算过程。每个特征矩阵有两个通道(channel1和channel2),并且每个通道的数据被组织成一个4元素的向量。图中详细展示了如何计算每个通道的均值和方差,以及如何进行标准化处理。先计算所有特征图中每个维度(通道)的均值,再计算每个维度的方差,得到向量和方差
,最后对每个元素进行标准化处理。
在训练神经网络的时候,我们通常一次处理一小批(batch)数据,而不是整个数据集。这样做可以让我们更高效地利用计算资源,并且有助于模型训练的稳定性。但是,在实际使用模型进行预测时,我们往往一次只处理一张图片,这时batch size就变成了1。如果再通过上述方法计算均值和方差就没有意义了。所以我们在训练过程中要去不断地计算每个batch的均值和方差,并使用移动平均(moving average)的方法记录统计的均值和方差,在训练完后我们可以近似认为所统计的均值和方差就等于整个训练集的均值和方差。在预测时,即使batch size为1,我们也可以利用这些统计量来进行标准化处理,从而确保模型的稳定性和预测性能。
在原论文公式中还有 ,
 两个参数。是用来调整数值分布的方差大小,是用来调节数值均值的位置。这两个参数是在反向传播过程中学习得到的,的默认值是1,的默认值是0。
1.3 动量(Momentum)方法
在训练过程中,均值 和方差
 是通过计算当前批次数据得到的,记为为
 和
 ,而验证以及预测过程中所使用的均值方差是一个新的统计量,记为
 和
 。动量方法通常用于优化算法中,以加速收敛并避免陷入局部最小值。在更新全局统计量时,动量方法通过结合新计算的统计量和旧的统计量来平滑更新过程。和的具体更新策略如下,其中momentum默认取0.1:
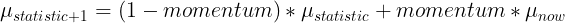
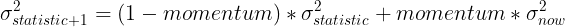
需要注意的是:
-
在pytorch中对当前批次feature进行bn处理时所使用的
 是总体方差,计算公式如下:
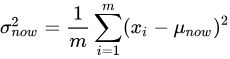
-
在更新统计量
 时采用的是样本方差,计算公式如下:
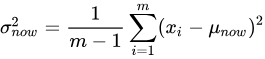
为什么在更新统计量时使用样本方差?这样做的目的是逐渐将新的样本方差融入到全局统计量中,同时保留大部分旧的统计信息,以避免因单个批次的异常值而对全局统计量产生过大影响。
1.4 使用pytorch进行验证
在 PyTorch 中,批量归一化(Batch Normalization,BN)是一种常用的正则化和加速训练的技术,可以通过自定义一个 bn_process 函数来实现类似的功能,并与 PyTorch 官方的 BatchNorm 模块进行对比验证。
import numpy as np
import torch.nn as nn
import torch


def bn_process(feature, mean, var):
    feature_shape = feature.shape
    for i in range(feature_shape[1]):
        # [batch, channel, height, width]
        feature_t = feature[:, i, :, :]
        mean_t = feature_t.mean()
        # 总体标准差
        std_t1 = feature_t.std()
        # 样本标准差
        std_t2 = feature_t.std(ddof=1)

        # bn process
        # 这里记得加上eps和pytorch保持一致
        feature[:, i, :, :] = (feature[:, i, :, :] - mean_t) / np.sqrt(std_t1 ** 2 + 1e-5)
        # update calculating mean and var
        mean[i] = mean[i] * 0.9 + mean_t * 0.1
        var[i] = var[i] * 0.9 + (std_t2 ** 2) * 0.1
    print(feature)


# 随机生成一个batch为2,channel为2,height=width=2的特征向量
# [batch, channel, height, width]
feature1 = torch.randn(2, 2, 2, 2)
# 初始化统计均值和方差
calculate_mean = [0.0, 0.0]
calculate_var = [1.0, 1.0]
# print(feature1.numpy())

# 注意要使用copy()深拷贝
bn_process(feature1.numpy().copy(), calculate_mean, calculate_var)

bn = nn.BatchNorm2d(2, eps=1e-5)
output = bn(feature1)
print(output)
自定义 bn_process 函数
def bn_process(feature, mean, var):
    feature_shape = feature.shape
    for i in range(feature_shape[1]):
        # [batch, channel, height, width]
        feature_t = feature[:, i, :, :]
        mean_t = feature_t.mean()
        # 总体标准差
        std_t1 = feature_t.std()
        # 样本标准差
        std_t2 = feature_t.std(ddof=1)

        # bn process
        # 这里记得加上eps和pytorch保持一致
        feature[:, i, :, :] = (feature[:, i, :, :] - mean_t) / np.sqrt(std_t1 ** 2 + 1e-5)
        # update calculating mean and var
        mean[i] = mean[i] * 0.9 + mean_t * 0.1
        var[i] = var[i] * 0.9 + (std_t2 ** 2) * 0.1
    print(feature)
功能解释
-
输入参数:
-
feature:输入特征张量,形状为[batch, channel, height, width]。 -
mean:一个列表,用于存储每个通道的累积均值。 -
var:一个列表,用于存储每个通道的累积方差。
-
-
逐通道处理:
-
遍历每个通道(
i),提取当前通道的特征张量feature_t。 -
计算当前通道的均值
mean_t和两种标准差:-
std_t1:总体标准差(ddof=0),用于归一化。 -
std_t2:样本标准差(ddof=1),用于更新累积方差。
-
-
-
批量归一化公式:
-
对当前通道的特征进行归一化:
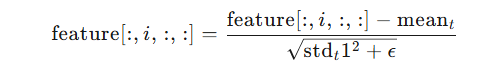
其中,
eps=1e-5是一个小常数,用于防止除零。
-
-
更新累积均值和方差:
-
使用动量(momentum)方法更新
mean和var: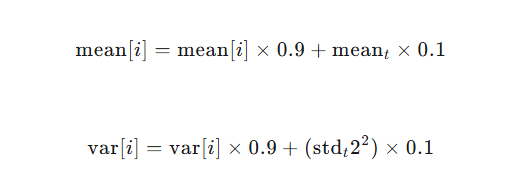
-
-
这里使用了0.9的动量系数,意味着新的统计量是旧统计量的90%加上新统计量的10%。
-
输出:
-
打印归一化后的特征张量。
-
使用自定义的Batch Normalization函数和PyTorch内置的Batch Normalization层
# 随机生成一个batch为2,channel为2,height=width=2的特征向量
# [batch, channel, height, width]
feature1 = torch.randn(2, 2, 2, 2)
# 初始化两个列表,分别用于存储每个通道的计算均值和方差
calculate_mean = [0.0, 0.0]
calculate_var = [1.0, 1.0]
# print(feature1.numpy())

# 注意要使用copy()深拷贝
bn_process(feature1.numpy().copy(), calculate_mean, calculate_var)

bn = nn.BatchNorm2d(2, eps=1e-5)
output = bn(feature1)
# 注意要使用copy()深拷贝
bn_process(feature1.numpy().copy(), calculate_mean, calculate_var)为什么要使用深拷贝?
-
这行代码首先将PyTorch张量
feature1转换为NumPy数组,并使用copy()方法进行深拷贝。这是因为bn_process函数可能会修改传入的数组,为了避免原始数据被修改,我们需要先进行拷贝。 -
然后,它调用
bn_process函数,传入拷贝后的数组、均值列表和方差列表。bn_process函数将对数据进行Batch Normalization处理,并更新均值和方差列表。
输出结果:
通过自定义函数bn_process得到的结果: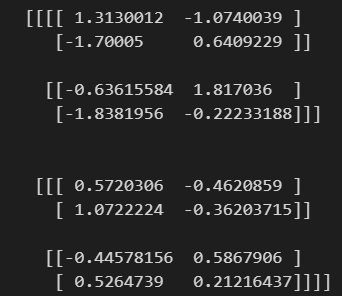
通过内置函数得到的结果: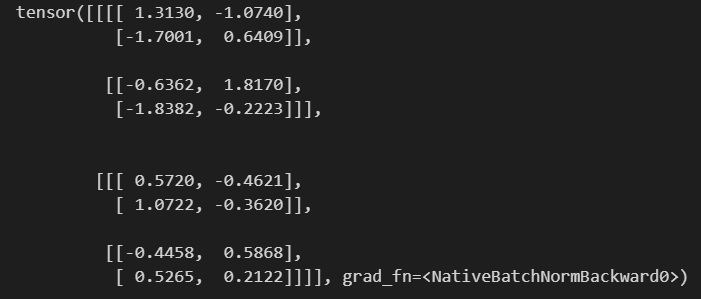
这两个输出展示了相同的数据,但以不同的格式呈现。第一个输出是NumPy数组格式,第二个输出是PyTorch张量格式。PyTorch张量包含了额外的信息,如梯度函数(grad_fn),这表明它参与了计算图,可以用于后续的梯度计算和反向传播。
1.5 使用BN时的注意事项
(1)训练时要将traning参数设置为True,在训练模式下,Batch Normalization层会根据当前批次的数据计算均值和方差,并使用这些实时计算的统计量来标准化数据。在验证时将trainning参数设置为False,在验证或测试模式下,Batch Normalization层会使用在训练过程中计算出的全局均值和方差的移动平均值来标准化数据,而不是使用当前批次的统计量。在pytorch中可通过创建模型的model.train()和model.eval()方法控制。
(2)batch size尽可能设置大点,设置小后表现可能很糟糕,设置的越大求的均值和方差越接近整个训练集的均值和方差。
(3)通常建议将Batch Normalization层放在卷积层和激活层之间。这样做的原因是,BN层可以标准化卷积层的输出,从而使得激活层的输入分布更加稳定,有助于加速训练过程并提高模型性能。当在卷积层后使用Batch Normalization层时,通常可以不使用偏置(bias)。这是因为BN层已经能够处理和调整输入数据的均值和方差,从而使得偏置变得不那么必要。实际上,一些研究表明,在这种情况下添加偏置可能不会带来额外的好处,甚至可能稍微降低模型性能。
1.6 BN的优点和缺点
Batch Normalization是一种强大的技术,可以显著提高深度学习模型的训练速度和稳定性。然而,它也有一些缺点,如增加计算量和内存消耗,以及对Batch Size的依赖。在选择是否使用BN时,需要根据具体的应用场景和资源限制来权衡这些优缺点。
| 特性 | 描述 | 适用条件 |
|---|---|---|
| 优点 | ||
| 加速训练 | 通过减少内部协变量偏移,可以加速网络训练过程。 | 当网络训练速度慢,需要快速收敛时。 |
| 提高稳定性 | 使得网络对初始化不敏感,有助于提高训练过程的稳定性。 | 当网络对初始化敏感,需要更稳定的训练过程时。 |
| 减少过拟合 | 可以作为正则化手段,有助于减少过拟合。 | 当模型有过度拟合的风险时。 |
| 允许更高学习率 | 由于训练更加稳定,可以使用更高的学习率。 | 当需要使用更高学习率加速训练时。 |
| 缺点 | ||
| 增加计算量 | 每个batch都需要计算均值和方差,增加了额外的计算量。 | 当计算资源有限,对效率要求极高时。 |
| 内存消耗 | 需要存储额外的均值和方差,增加了内存消耗。 | 当内存资源有限时。 |
| Batch依赖 | BN的效果依赖于Batch Size的大小,太小的Batch Size可能导致效果不佳。 | 当Batch Size太小,无法有效利用BN时。 |
| 不适用于小批量 | 在在线学习或小批量更新的场景下,BN可能不适用。 | 在非批量处理的场景下,如在线学习或增量学习。 |
| 可能影响特征学习能力 | 在某些情况下,BN可能会掩盖网络学习到的特征。 | 当需要网络学习到特定特征时。 |
| 需要调整超参数 | BN层引入了额外的超参数(如γ和β),需要调整。 | 当需要精细调整模型性能时。 |
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 25
 0
- 0


 已为社区贡献1条内容

所有评论(0)