pytorch学习记录-神经网络基础
一、神经元模型:像大脑细胞一样工作
比喻:
想象你是一个天气预报员,要预测明天是否会下雨。你会考虑三个因素:
- 湿度:今天的空气湿度高吗?
- 气压:气压是在升高还是降低?
- 云层:天空中是否有很多乌云?
每个因素都有不同的重要性(权重):
- 湿度的重要性:0.6(非常重要)
- 气压的重要性:0.3(比较重要)
- 云层的重要性:0.1(不太重要)
神经元的工作流程:
- 接收输入:获取三个因素的数值(比如湿度 80%,气压下降,云层覆盖率 90%)。
- 加权求和:把每个因素乘以它的重要性,然后相加。
- 加上偏置:偏置就像你的「直觉修正」,比如你觉得最近天气反常,需要额外加一点权重。
- 通过激活函数判断:把加权和的结果输入到一个函数中,得到最终预测(下雨或不下雨)。
二、激活函数:像开关一样做决定
比喻:
还是刚才的天气预报员。假设加权求和并加上偏置后的结果是 0.7。你需要一个规则来决定:
- 如果结果大于 0.5,就预测「下雨」;
- 如果结果小于 0.5,就预测「不下雨」。
这个「规则」就是激活函数。不同的激活函数有不同的规则:
1. Sigmoid 函数(二分类开关)
公式:
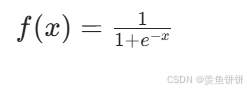
特点:
- 把任何输入值压缩到 0~1 之间。
- 输出可以理解为「概率」,比如 0.7 表示有 70% 的概率下雨。
- 缺点:当输入值很大或很小时,函数变得非常平缓,导致梯度消失(后面会解释)。
例子:
如果加权和是 0.7,经过 Sigmoid 函数后得到 0.668。因为 0.668 > 0.5,所以预测「下雨」。
2. ReLU 函数(过滤负数)
公式:
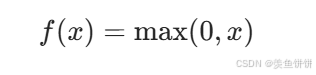
特点:
- 只保留正数部分,负数直接变成 0。
- 计算速度非常快,是深度学习中最常用的激活函数。
- 解决了梯度消失问题。
例子:
如果加权和是 - 0.3,经过 ReLU 后变成 0,表示「不下雨」;如果是 0.7,保持不变。
3. Tanh 函数(对称版 Sigmoid)
公式:
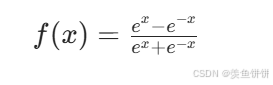
特点:
- 把输入值压缩到 -1~1 之间。
- 输出 0 表示中性,正数表示「下雨」,负数表示「不下雨」。
- 比 Sigmoid 更接近原点对称。
三、多层感知机(MLP):像流水线一样处理信息
比喻:
假设你是一个工厂老板,要生产「天气预报芯片」。这个芯片需要经过三道工序:
- 预处理:清洗和整理原始数据(湿度、气压、云层)。
- 特征提取:从预处理的数据中提取关键特征(比如「潮湿且气压下降」)。
- 决策输出:根据提取的特征,做出最终预测(下雨或不下雨)。
MLP 的结构:
- 输入层:接收原始数据(比如三个神经元分别对应湿度、气压、云层)。
- 隐藏层:处理数据的中间层,可以有多个(比如预处理层和特征提取层)。
- 输出层:产生最终结果(比如一个神经元输出「下雨概率」)。
前向传播:
数据从输入层进入,依次通过每个隐藏层,最后到达输出层的过程。每一层的神经元都对输入进行加权求和并应用激活函数,然后把结果传递给下一层。
四、损失函数:衡量预测有多差
比喻:
还是天气预报的例子。假设你预测明天有 70% 的概率下雨,但实际上没有下雨。你的预测有多「错」呢?损失函数就是用来量化这个错误的。
1. MSE(均方误差)
适用场景:预测连续值(比如温度、房价)。
公式:
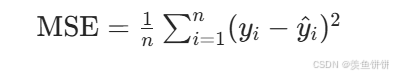
例子:
如果你预测明天温度是 25℃,但实际是 23℃,那么 MSE = (25 - 23)² = 4。MSE 越小,预测越准确。
2. 交叉熵损失
适用场景:分类问题(比如下雨 / 不下雨、猫 / 狗)。
公式:
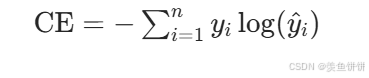
例子:
如果你预测下雨的概率是 0.7(即不下雨的概率是 0.3),但实际没有下雨(真实标签是 0),那么交叉熵损失 = - (0 × log (0.7) + 1 × log (0.3)) ≈ 1.2。
直观理解:预测的概率越偏离真实标签,损失越大。
五、优化器:像登山者一样找最优解
比喻:
假设你站在一个山谷里,目标是找到山谷的最低点(即损失函数最小的地方)。你看不到全局地形,只能看到脚下的一小片区域。你应该如何移动?
1. SGD(随机梯度下降)
策略:
- 每次只看眼前的一小片区域,找到最陡峭的下坡方向(梯度的反方向)。
- 沿着这个方向走一小步(步长由学习率决定)。
- 重复这个过程,直到到达最低点或无法继续下降。
问题:
- 如果学习率太大,可能会跳过最低点,甚至越走越高(发散)。
- 如果学习率太小,会走得非常慢,需要很长时间才能到达最低点。
2. Adam(自适应学习率优化器)
改进:
- 不仅考虑当前的梯度方向,还考虑过去的移动方向(动量),避免在局部最小值附近震荡。
- 自适应调整每个参数的学习率,对频繁更新的参数使用较小的学习率,对不频繁更新的参数使用较大的学习率。
比喻:
就像一个聪明的登山者,他会记住自己之前的路线(动量),并且在陡峭的地方走小步,在平缓的地方走大步。
六、完整训练流程:从数据到模型
还是用天气预报的例子,我们来训练一个神经网络:
1. 准备数据
- 训练数据:过去 100 天的天气数据(湿度、气压、云层)和对应的结果(是否下雨)。
- 测试数据:另外 20 天的数据,用于评估模型的泛化能力。
2. 初始化模型
- 随机初始化所有参数(权重和偏置),就像随机猜测每个因素的重要性。
3. 前向传播
- 输入一天的天气数据,通过网络计算出预测结果(下雨概率)。
4. 计算损失
- 用交叉熵损失函数计算预测结果与真实标签的差异。
5. 反向传播
- 核心思想:计算每个参数对损失的影响程度(梯度),然后调整参数来减小损失。
- 比喻:
假设你预测错了,你需要知道哪些因素导致了错误。比如,你高估了湿度的重要性,那么下次就应该降低湿度的权重。
6. 参数更新
- 使用优化器(如 Adam)根据梯度调整参数。
7. 重复步骤 3-6
- 对训练数据中的每一条记录重复上述过程,直到损失函数不再降低或达到最大训练次数。
七、PyTorch 代码实现:预测明天是否下雨
下面是一个用 PyTorch 实现的简单神经网络,用于预测明天是否下雨。代码已经添加了详细注释,确保你能看懂每一步:
import torch
import torch.nn as nn
import torch.optim as optim
from torch.utils.data import DataLoader, TensorDataset

# 1. 准备数据(示例数据,实际应用中需要真实数据)
# 特征:[湿度, 气压变化, 云层覆盖率]
X = torch.tensor([
    [0.8, -0.2, 0.9],  # 潮湿、气压下降、多云 -> 下雨
    [0.6, 0.1, 0.5],   # 中等湿度、气压上升、少云 -> 不下雨
    [0.9, -0.3, 0.8],  # 潮湿、气压大幅下降、多云 -> 下雨
    [0.4, 0.2, 0.3],   # 干燥、气压上升、少云 -> 不下雨
    [0.7, -0.1, 0.7]   # 潮湿、气压轻微下降、多云 -> 下雨
], dtype=torch.float32)

# 标签:0=不下雨,1=下雨
y = torch.tensor([1, 0, 1, 0, 1], dtype=torch.float32).view(-1, 1)

# 创建数据加载器
dataset = TensorDataset(X, y)
dataloader = DataLoader(dataset, batch_size=2, shuffle=True)

# 2. 定义模型
class RainPredictor(nn.Module):
    def __init__(self):
        super(RainPredictor, self).__init__()
        # 输入层到隐藏层:3个特征 -> 4个神经元
        self.hidden = nn.Linear(3, 4)
        # 隐藏层到输出层:4个神经元 -> 1个输出(下雨概率)
        self.output = nn.Linear(4, 1)
        # ReLU激活函数
        self.relu = nn.ReLU()
        # Sigmoid激活函数,将输出压缩到0~1之间
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        x = self.relu(self.hidden(x))  # 隐藏层计算 + ReLU激活
        x = self.sigmoid(self.output(x))  # 输出层计算 + Sigmoid激活
        return x

# 3. 初始化模型、损失函数和优化器
model = RainPredictor()
criterion = nn.BCELoss()  # 二元交叉熵损失函数,适用于二分类问题
optimizer = optim.Adam(model.parameters(), lr=0.01)  # Adam优化器

# 4. 训练模型
def train_model(model, dataloader, criterion, optimizer, epochs=100):
    for epoch in range(epochs):
        epoch_loss = 0.0
        for inputs, labels in dataloader:
            # 清零梯度
            optimizer.zero_grad()

            # 前向传播
            outputs = model(inputs)
            loss = criterion(outputs, labels)

            # 反向传播
            loss.backward()

            # 参数更新
            optimizer.step()

            epoch_loss += loss.item()

        # 打印每个epoch的损失
        if (epoch + 1) % 10 == 0:
            print(f"Epoch {epoch+1}/{epochs}, Loss: {epoch_loss/len(dataloader):.4f}")

# 5. 训练模型
train_model(model, dataloader, criterion, optimizer, epochs=50)

# 6. 测试模型
def predict_rain(model, humidity, pressure_change, cloud_coverage):
    # 准备输入数据
    input_data = torch.tensor([[humidity, pressure_change, cloud_coverage]], dtype=torch.float32)

    # 模型预测
    model.eval()  # 设置为评估模式
    with torch.no_grad():  # 不计算梯度
        prediction = model(input_data)
        rain_probability = prediction.item()

    # 判断结果
    result = "下雨" if rain_probability > 0.5 else "不下雨"
    print(f"预测结果:{result} (概率:{rain_probability:.2f})")

# 测试一个新的天气情况
predict_rain(model, 0.85, -0.15, 0.8)  # 潮湿、气压下降、多云
1. 准备数据:教 AI 认识天气规律
我们给 AI 看了 5 天的天气数据,包括:
- 特征 (X):湿度、气压变化、云层覆盖率(比如
[0.8, -0.2, 0.9]表示潮湿、气压下降、多云) - 标签 (y):这一天是否下雨(
1= 下雨,0= 不下雨)
AI 需要从这些数据中 "学习" 天气和下雨之间的关系。就像你看到蚂蚁搬家,就知道可能要下雨一样,AI 也要找出类似的规律。
2. 定义模型:造一个会思考的 "天气大脑"
我们创建了一个名为RainPredictor的神经网络模型,它就像一个小脑袋,有三层:
- 输入层:接收 3 个天气数据(湿度、气压、云层)
- 隐藏层:4 个神经元,负责 "思考" 这些数据(就像你的大脑细胞在分析信息)
- 输出层:1 个输出,表示下雨的概率(0~1 之间,比如 0.8 表示 80% 会下雨)
模型里有两个 "开关":
- ReLU:让隐藏层只关注重要的信息(比如气压下降比上升更重要)
- Sigmoid:把输出压缩到 0~1 之间,方便我们判断是否下雨
3. 初始化:给模型 "发工具"
- 损失函数 (BCELoss):用来判断模型预测得有多错(就像老师批改作业打分)
- 优化器 (Adam):告诉模型如何调整自己的 "思考方式",让预测更准确(就像学生根据错题改正)
model.parameters():#告诉优化器 "需要调整哪些参数"(就像告诉学生哪些题目需要重点复习)。
                    # lr=0.01:学习率(Learning Rate),控制每次调整的 "步子大小"。
4. 训练模型:让 AI"刷题" 学习
我们让模型看这些天气数据 50 遍(epochs=50),每看一遍就:
- 预测:根据天气数据猜是否下雨
- 计算损失:对比预测结果和真实标签,看看猜得有多错
- 调整模型:根据错误程度,微调模型的 "思考方式"(更新参数)
每 10 遍打印一次 "错题率"(损失值),我们希望这个值越来越小。就像学生刷题,错题会越来越少。
函数整体作用
train_model函数的目标是让模型通过反复学习数据,逐渐提高预测准确率。参数说明:
model:要训练的神经网络(天气预测模型)dataloader:数据加载器,批量提供训练数据criterion:损失函数,衡量预测误差optimizer:优化器,负责调整模型参数epochs=100:学习的 "轮数",即把全部数据看 100 遍
训练的核心流程:Epoch 和 Batch
训练过程就像学生刷题:
- Epoch:把所有题目(数据)做一遍。
- Batch:把题目分成小组,每次做一组。
代码中的嵌套循环:
for epoch in range(epochs):  # 重复学习100轮
    for inputs, labels in dataloader:  # 每次处理一批数据
        # ...训练步骤...
每一轮训练的具体步骤
1. 清零梯度 (optimizer.zero_grad())
- 梯度:表示模型参数需要调整的方向和大小。
- 为什么要清零?
因为 PyTorch 会累积梯度,每次更新参数后需要手动清零,否则会影响下一次更新。
类比:就像学生做完一组题后,要清空草稿纸重新计算。
2. 前向传播 (outputs = model(inputs) 和 loss = criterion(outputs, labels))
- 前向传播:模型根据输入数据计算预测结果。
- 计算损失:对比预测结果和真实标签,得到误差值。
类比:学生做题 (model(inputs)),老师批改打分 (criterion)。
3. 反向传播 (loss.backward())
- 反向传播:根据损失值,计算每个参数需要调整的梯度。
类比:老师告诉学生哪些题错了,错在哪里(比如 "这道题应该用公式 A,而不是公式 B")。
4. 参数更新 (optimizer.step())
- 参数更新:优化器根据梯度,调整模型的参数。
类比:学生根据老师的反馈,改正自己的解题思路。
5. 记录本轮损失 (epoch_loss += loss.item())
- 累加当前批次的损失值,用于统计本轮的平均损失。
打印训练进度
if (epoch + 1) % 10 == 0:
    print(f"Epoch {epoch + 1}/{epochs}, Loss: {epoch_loss / len(dataloader):.4f}")
- 每 10 轮打印一次平均损失值。
- 损失值:越小越好,表示模型预测越来越准确。
类比:就像学生的错题率越来越低。
总结:训练过程的类比
整个训练过程可以想象成:
- 老师给学生一套题目(数据)
- 学生做题(前向传播)
- 老师批改打分(计算损失)
- 老师指出错误(反向传播)
- 学生改正学习方法(参数更新)
- 重复这个过程 100 次,直到学生几乎不出错
5. 测试模型:考一考 AI
训练完成后,我们用一个新的天气数据测试模型:
- 湿度 0.85(很潮湿)
- 气压变化 - 0.15(气压下降)
- 云层覆盖率 0.8(多云)
模型输出一个概率值(比如 0.78),表示它认为有 78% 的概率会下雨。如果概率大于 50%,就预测 "下雨",否则预测 "不下雨"。
总结:AI 如何预测下雨?
这个模型就像一个聪明的小学生,通过学习历史天气数据,找到了一些规律:
- 湿度高、气压下降、云层多 → 下雨概率大
- 湿度低、气压上升、云层少 → 下雨概率小
八、常见问题解答
-
为什么需要激活函数?
如果没有激活函数,无论神经网络有多少层,输出都是输入的线性组合,只能解决线性问题。激活函数引入了非线性,让神经网络可以学习复杂的模式。 -
学习率是什么?如何设置?
- 学习率控制参数更新的步长。如果太大,模型可能无法收敛;如果太小,训练会非常缓慢。
- 通常从 0.001 或 0.01 开始尝试,根据训练过程中的损失变化调整。
-
什么是过拟合?如何避免?
- 过拟合:模型在训练数据上表现很好,但在新数据上表现很差。
- 避免方法:增加更多训练数据、使用正则化(如 Dropout)、提前停止训练。
-
为什么神经网络需要多层?
- 多层可以让模型学习不同层次的抽象特征。例如,第一层可能学习边缘和线条,第二层学习形状,第三层学习整体对象。
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)