THE UNSEEN BIAS: HOW NORM DISCREPANCY IN PRE-NORM MLLMS LEADS TO VISUAL INFORMA- TION LOSS论文解读
ABSTRACT
多模态大语言模型(MLLMs)融合了预训练视觉编码器与语言模型,展现出卓越的性能。然而,这类模型因普遍采用预归一化(Pre-Norm)架构,存在一个隐蔽却关键的缺陷:高范数视觉标记与低范数文本标记之间存在严重的范数差异。在本研究中,我们通过严谨的理论分析证明,这种失衡并非静态问题,反而会引发非对称更新动态——高范数的视觉标记会表现出表征惯性,使其语义变换的速度远慢于文本标记,这从根本上阻碍了有效的跨模态特征融合。
我们在多款主流多模态大语言模型上开展的实证验证表明,这一理论推导的动态规律(范数差异的持续存在及其引发的非对称更新速率)是一种普遍存在的现象。基于这一研究发现,我们提出了一种极为简洁且高效的解决方案:在视觉投影器后插入一个经精心初始化的层归一化(LayerNorm)层,以此实现范数对齐。在LLaVA-1.5架构上开展的实验结果显示,该改进方法不仅让模型在各类多模态基准测试中取得显著的性能提升,更值得关注的是,在多任务语言理解评估(MMLU)等纯文本任务的测评中,模型性能也得到了改善。这表明,解决该架构层面的失衡问题,能够让模型的综合性能得到全方位提升。
INTRODUCTION
1. MLLMs的发展现状与主流架构
近年来,MLLMs取得显著进展,在各类跨模态任务中表现出强大能力。其主流架构范式为:
- 核心组件:预训练视觉编码器(VE,通常是Vision Transformer,ViT)与预训练语言模型(LLM)耦合;
- 工作流程:VE将图像分割为图像块并编码为“视觉token”,再通过一个轻量级投影适配器(adapter),将视觉token映射到LLM的词嵌入空间,使原本面向文本的LLM能够理解视觉信息。
2. MLLMs的固有局限与核心问题定位
现有MLLMs存在明显缺陷:一是难以感知细粒度视觉细节;二是自注意力机制中,视觉token获得的关注度远低于文本token。而这些问题的根源,在于当前MLLMs普遍采用的Pre-Norm架构设计。
3. Pre-Norm架构的原理与弊端
- 架构定义:归一化操作在主计算块(F)之前执行,残差更新公式为 (h(l+1)=h(l)+F(Norm(h(l)))h^{(l+1)}=h^{(l)}+F(Norm\left(h^{(l)}\right))h(l+1)=h(l)+F(Norm(h(l))));
- 核心优势:残差路径 (h(l))(h^{(l)})(h(l)) 保持不变,形成类恒等连接,梯度流更平滑,可避免深层网络的梯度消失问题,易于训练;
- 关键副作用:残差和的输出未经过重新归一化,导致隐藏状态的方差及L2范数随网络深度累积增长;
- 跨模态矛盾:视觉token由深度Pre-Norm架构的ViT生成,本身范数极高,而LLM的文本token范数极低,二者在共享的Pre-Norm LLM骨干中协同处理时,形成严重的范数失衡。
4. 范数失衡引发的核心动态问题
理论分析表明,范数失衡并非静态问题,而是会诱发“非对称更新动态”:
- 高范数的视觉token会产生“表征惯性”(representational inertia),语义变换速度远慢于低范数的文本token;
- 这种速度差异导致二者向统一多模态空间收敛的速率不匹配,从根本上损害跨模态特征融合;
- 关键说明:该动态分歧并非视觉与文本信息的固有属性,而是Pre-Norm设计与MLLMs主流范式相互作用产生的架构缺陷。
5. 研究的解决方案框架与核心贡献
- 初步干预思路:通过实证验证,主流开源视觉语言(VL)模型中均存在范数差异和非对称更新速率的普遍现象,因此提出插入归一化层强制范数对齐;
- 优化瓶颈与解决:现代LLM的文本嵌入范数极低,归一化增益需初始化为极小值,易引发梯度消失(导致视觉编码器脱离监督),为此设计全局权重补偿(GWC)机制,解耦前向范数压缩与反向梯度幅度,保障有效学习;
- 三大核心贡献:
- 首次识别并形式化分析Pre-Norm MLLMs中的跨模态范数差异问题,揭示“非对称更新动态”与“表征惯性”;
- 通过广泛实证,验证理论预测的现象在主流模型中普遍存在;
- 提出融合GWC的梯度感知范数对齐方案,不仅提升多模态任务性能,还能改善纯文本任务表现,实现模型整体能力提升。
2 PRELIMINARIES
2.1 自注意力机制(SELF-ATTENTION)
自注意力是Transformer的计算核心,其作用是为输入序列的不同位置分配注意力权重。
- 输入为隐藏状态序列(H∈RN×D)(H \in \mathbb{R}^{N ×D})(H∈RN×D)((N)为token数,(D)为特征维度);
- 先通过可学习的权重矩阵(overlinewQ)、(wK)、(WV)(overline{w}_{Q})、(w_{K})、(W_{V})(overlinewQ)、(wK)、(WV),将输入线性投影为查询(Q)、键(K)、值(V);
- 核心计算第一步为求解未归一化的点积分数(QKT)(Q K^{T})(QKT),为后续注意力权重计算提供基础。
2.2 Transformer中的归一化层(NORMALIZATION LAYERS IN TRANSFORMERS)
归一化层是稳定深度网络训练的关键,通过控制激活值分布,防止其幅度爆炸或消失,对多模态模型尤为重要(需处理统计特性不同的视觉/文本特征)。论文重点介绍了两种Transformer中最常用的归一化方式,均包含可学习的增益(g)参数以恢复模型表达能力:
- 层归一化(LayerNorm)
- 对每个token的特征维度独立归一化,先去均值再归一化方差;
- 公式:(LayerNorm(x)=x−E[x]Var[x]+ϵ⊙g+β)(LayerNorm (x)=\frac{x-\mathbb{E}[x]}{\sqrt{Var[x]+\epsilon}} \odot g+\beta)(LayerNorm(x)=Var[x]+ϵx−E[x]⊙g+β)((β)(\beta)(β)为偏置参数,(ϵ)(\epsilon)(ϵ)为防止分母为0的极小值)。
- 均方根归一化(RMSNorm)
- LayerNorm的简化高效变体,舍弃去均值步骤,仅通过向量的均方根做归一化;
- 公式:(RMSNorm(x)=x1D∥x∥22+ϵ⊙g)(RMSNorm(x)=\frac{x}{\sqrt{\frac{1}{D}\| x\| _{2}^{2}+\epsilon}} \odot g)(RMSNorm(x)=D1∥x∥22+ϵx⊙g);
- 特点:计算成本更低,是现代LLM(如Llama)的主流选择。
2.3 Pre-Norm与Post-Norm残差架构(THE PRE-NORM VS. POST-NORM RESIDUAL ARCHITECTURE)
这是本节的核心内容,Transformer块的本质是加性更新机制,通过残差连接优化token表征,而归一化层的放置位置是核心设计选择,直接决定了架构的特性。论文先定义了Transformer块的基础更新公式:
[h(l+1)=h(l)+Δh(l)][h^{(l+1)}=h^{(l)}+\Delta h^{(l)}][h(l+1)=h(l)+Δh(l)]
其中(h(l))(h^{(l)})(h(l))为前一状态(残差连接的初始token表征),(Δh(l))(\Delta h^{(l)})(Δh(l))为更新向量(由自注意力/前馈网络子层计算),(h(l+1))(h^{(l+1)})(h(l+1))为更新后的新状态。
在此基础上,详细对比了Post-Norm(原始架构)和Pre-Norm(主流架构)的设计、公式、优势与缺陷,核心差异如下表:
| 架构类型 | 核心公式 | 核心优势 | 关键缺陷 |
|---|---|---|---|
| Post-Norm | (h(l+1)=Norm(h(l)+Sublayer(h(l))))(h^{(l+1)}=Norm\left(h^{(l)}+Sublayer\left(h^{(l)}\right)\right))(h(l+1)=Norm(h(l)+Sublayer(h(l))))(归一化在残差求和后执行) | 1. 直接归一化输出路径,表征保真度高; 2. 无网络深度导致的范数退化问题,表征能力更强 | 梯度需经过每一层的归一化层,深层网络梯度流受阻,训练难度大 |
| Pre-Norm | (Δh(l)=Sublayer(Norm(h(l))))(\Delta h^{(l)}=Sublayer\left(Norm\left(h^{(l)}\right)\right))(Δh(l)=Sublayer(Norm(h(l)))); (h(l+1)=h(l)+Δh(l))(h^{(l+1)}=h^{(l)}+\Delta h^{(l)})(h(l+1)=h(l)+Δh(l))(归一化在子层计算前、残差分支内执行) | 1. 残差连接为无干扰的类恒等路径,梯度流平滑; 2. 深层模型训练更稳定、更容易,成为大模型主流设计 | 最终输出(h(l+1))(h^{(l+1)})(h(l+1))从未被重新归一化,隐藏状态的方差和L2范数随网络深度累积增长,为多模态模型的范数失衡埋下隐患 |
本节的收尾核心结论
Pre-Norm架构的范数累积特性,结合MLLMs的主流范式(将预训练视觉编码器的特征注入LLM),成为跨模态范数失衡的根源:
- 视觉编码器是深度Pre-Norm网络,其输出的视觉token会因范数累积形成高范数;
- LLM的文本token本身为低范数;
- 二者在共享的Pre-Norm LLM骨干中协同处理时,初始的范数差异会被进一步放大,最终引发后续理论分析的非对称更新动态。
整体而言,预备知识部分的所有内容均为后续的范数诱导解耦效应理论分析做铺垫,明确了Transformer架构的核心设计细节,以及Pre-Norm架构的固有特性如何成为MLLMs跨模态融合失效的底层原因。
3 THEORETICAL ANALYSIS OF NORM-INDUCED DECOUPLING EFFECT
3.1 ANALYTICAL FRAMEWORK AND ASSUMPTIONS(分析框架与假设)
为捕捉Pre-Norm架构的核心动态、简化理论推导并保证分析的可处理性,作者提出了四个核心简化假设,作为后续所有理论证明的前提,所有推导均基于这些假设展开:
- 模态范数失衡:区分两种情况,失衡情况(k=∥hvis∥2∥htxt∥2>1)(k=\frac{\left\|h_{vis}\right\|_{2}}{\left\|h_{txt}\right\|_{2}}>1)(k=∥htxt∥2∥hvis∥2>1)(视觉token范数远高于文本)、理想平衡情况(k=1)(k=1)(k=1)(二者范数相等);
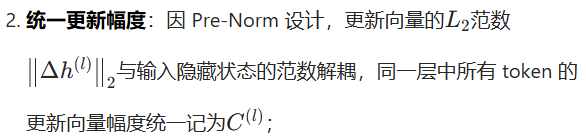
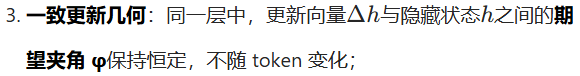
- 随机旋转方向:更新向量中负责表征旋转的分量,其方向在对应子空间中服从对称分布。
3.2 ASYMMETRIC ANGULAR VELOCITY AND GEOMETRIC DIVERGENCE(非对称角速度与几何发散)
作者引入有效角速度的概念量化token表征的方向变化速率,推导了范数失衡引发的更新角速度非对称性,并证明其会加速视觉与文本模态的几何发散,核心结论:
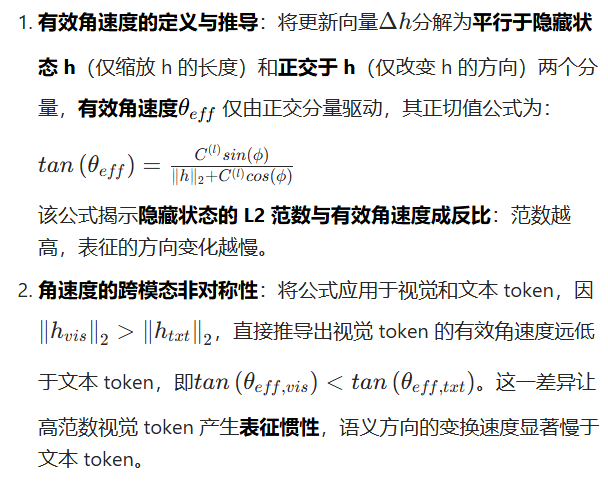
- 加速的几何发散:作者在附录中严谨证明,这种角速度的非对称性会直接导致视觉与文本表征的几何发散速度大幅加快,二者在语义空间中的相对位置偏离越来越大,最终削弱注意力机制依赖的跨模态相似度信号。
3.3 SIGNAL DEGRADATION AND ATTENTION COLLAPSE(信号退化与注意力坍塌)
这一节是理论分析的核心,论证了几何发散对MLLMs自注意力机制的破坏性影响,最终解释了范数失衡如何导致视觉信息丢失,核心逻辑与结论:
- 语义对齐的机械性障碍:正常的多模态模型中,文本查询token (q)(q)(q) 需要与语义相关的视觉键token (k+)(k^+)(k+) 在共享度量空间中几何对齐,以最大化二者的点积值,实现有效跨模态检索。但视觉token的表征惯性使其更新速度远慢于文本token,即使文本token快速调整方向以匹配视觉信息,视觉token也无法及时响应,导致语义相关的视觉-文本对存在持续的角度失准,其点积信号(Srelproptoq⋅k+)(S_{rel } propto q \cdot k^{+})(Srelproptoq⋅k+)被这种几何滞后从根本上限制。
- 信噪比(SNR)的核心坍塌:注意力机制的有效性依赖于有效信号与噪声的差距,而范数失衡仅影响有效信号,对噪声无作用:
- 有效信号:语义相关对的点积信号因角度失准被持续压制;
- 背景噪声:语义无关的视觉-文本对在高维空间中本就近似正交,表征惯性和几何发散对其无系统性影响,噪声水平保持恒定(近似为0)。
这种“信号压制、噪声不变”的状态直接导致注意力机制的信噪比坍塌。
- 注意力机制的功能失效:自注意力机制由Softmax函数驱动,信噪比坍塌让Softmax无法生成高辨识度的权重分布,失去了精准区分目标视觉区域和无关背景的能力。作者在附录中从数学上证明,失衡情况下语义相关对的期望注意力分数显著低于平衡情况,即:
[E[Srel(imb)]<E[Srel(bal)]][\mathbb{E}\left[S_{rel }^{(imb) }\right]<\mathbb{E}\left[S_{rel }^{(bal)}\right]][E[Srel(imb)]<E[Srel(bal)]]
这一结论从第一性原理解释了基线MLLMs中注意力图模糊、无聚焦的实验现象,而注意力的失效最终导致模型无法有效提取和利用视觉信息,引发视觉信息丢失。
4 EMPIRICAL VALIDATION: PROBING THE DYNAMICS OF NORM IMBALANCE
RQ1:模态接口是否存在显著的初始范数差异?
研究问题:视觉编码器输出的视觉token与LLM的文本token,在进入MLLM融合环节的模态接口处,是否存在理论假设的严重L2范数失衡?
实验方法:测量4个代表性视觉编码器(CLIP-ViT-large、SigLIP-SO-400m、SigLIP2-SO-400m、MoonViT-SO-400M)的输出L2范数,同时计算3个主流LLM(Qwen2.5-7B-Instruct、Qwen3-8B-Instruct、Llama3.2-3B-Instruct)文本嵌入层的平均L2范数,做跨模态对比。
核心结果:视觉编码器输出的平均L2范数为29.30 ~ 72.17,而LLM文本嵌入的平均L2范数仅为0.80~1.38,二者存在数十倍的量级差距;该差异无法自然消除,原因是视觉编码器的对比预训练流程,本就未设计为与外部LLM的词嵌入空间做范数对齐。
RQ2:投影适配器能否调和模态间的初始范数差异?
研究问题:MLLMs中负责将视觉token映射到LLM嵌入空间的投影适配器,是否能在视觉token进入LLM骨干网络前,消除二者的范数差异?
实验方法:分析4个主流MLLMs(LLaVA-v1.5、Qwen-2.5-VL、KimiVL、GLM-4.1V)的视觉token在投影适配器处理前/后的L2范数,并与各模型自身的文本token范数对比。
核心结果:
- 不同投影适配器的范数压缩能力参差不齐:KimiVL、GLM-4.1V的适配器能实现显著压缩,但视觉token范数仍比文本高约5倍;LLaVA-v1.5的适配器无压缩效果,视觉token投影后范数反而从28.71膨胀至39.96;
- 所有模型均无法彻底调和范数差异:即便集成了内部归一化层的模型(除LLaVA-1.5外),视觉与文本token仍存在数量级的范数差距;
- 发现被动补偿现象:Qwen2.5-VL、Qwen2-VL等模型会出现文本嵌入范数系统性膨胀,说明模型会低效地调整静态嵌入参数,被动补偿模态接口的巨大范数差距。
RQ3:视觉与文本隐藏状态是否存在理论预测的非对称更新速率?
研究问题:视觉和文本token的隐藏状态,是否会因范数失衡表现出理论中预测的非对称更新动态?这是对理论核心机制最直接的实证检验。
实验方法:采用层间余弦相似度作为表征更新速率的代理指标(相似度越高,代表token的表征方向变化越小,更新速率越慢,对应理论中的有效角速度越低),计算主流MLLMs各层中视觉、文本token的该指标并对比。
核心结果:
- 直接验证了理论预测:所有被测连续投影型MLLMs中,视觉token的层间余弦相似度均显著高于文本token,即视觉token更新速率更慢,存在明确的非对称更新;
- 二者呈强正相关:初始范数差异越大,更新速率的非对称性越显著(如LLaVA-1.5、Qwen2.5-VL范数差距极大,非对称现象明显;KimiVL、GLM-4.1V范数差距小,非对称现象较弱),为理论分析提供了强相关证据。
RQ4:采用概率视觉分词的架构是否仍存在范数差异及相关动态问题?
研究问题:范数差异及其引发的动态问题,是否在非连续投影的MLLM架构中依然存在?以采用概率视觉分词的Ovis 2.5为测试对象(区别于LLaVA-1.5的连续特征投影,Ovis 2.5使用由SigLIP2编码器得到的离散视觉词汇)。
实验方法:测量Ovis 2.5中离散视觉词汇与文本词汇的平均L2范数,同时计算二者的层间余弦相似度,验证其范数差异和更新速率特性。
核心结果:
- 静态范数差异仍显著:Ovis 2.5的视觉词汇平均L2范数为64.00,文本词汇仅1.38,二者差距依旧巨大,且视觉词汇的范数分布高度集中(标准差仅0.71);
- 无明显的非对称更新速率:尽管存在范数差距,Ovis 2.5中视觉与文本token的层间余弦相似度曲线高度重叠,更新速率保持同步,说明离散视觉分词范式能天然缓解高范数输入的表征惯性,规避了理论中预测的非对称更新动态。
5 EXPERIMENTS
5.1 METHOD: GRADIENT-AWARE NORM ALIGNMENT(梯度感知范数对齐方法)
作者提出一种极简且针对性的解决方案,核心是在视觉投影器后插入单个精心初始化的LayerNorm层强制视觉与文本token的范数对齐,并设计全局权重补偿(GWC)机制解决该方法带来的梯度消失优化瓶颈,整体分为对齐目标确定、优化困境、GWC机制解决三部分:
- 确定范数对齐目标
先计算语言模型文本嵌入的目标L2范数T:对语言模型词嵌入矩阵中所有非零向量求平均L2范数;再将新增LayerNorm层的可学习增益参数(g)初始化为标量(ginit=T/D)(g_{init}=T/\sqrt{D})(ginit=T/D)((D)(D)(D)为特征维度),让视觉token范数直接匹配文本token的范数尺度。 - 暴露的优化困境
现代LLM的文本嵌入范数极低(如维度4096时L2范数仅≈1),导致(ginit)(g_{init})(ginit)需初始化为极小值(如≈0.01);而标准反向传播中,流向视觉编码器的梯度会被该增益参数缩放,极小的(g)(g)(g)会触发梯度消失问题,让视觉编码器彻底脱离监督,无法有效学习。 - 全局权重补偿(GWC)机制
通过反向钩子(backward hook) 实现,解耦前向范数压缩与反向梯度幅度,核心公式为:
[Backward(∇x^L)=(∇yL⊙g)×1g‾][Backward\left(\nabla_{\hat{x}} \mathcal{L}\right)=\left(\nabla_{y} \mathcal{L} \odot g\right) × \frac{1}{\overline{g}}][Backward(∇x^L)=(∇yL⊙g)×g1]
其中(g‾)(\overline{g})(g)是增益向量(g)(g)(g)的均值绝对值,将梯度乘以1g‾\frac{1}{\overline{g}}g1可抵消极小(g)(g)(g)的梯度缩放效应,让梯度流恢复至单位尺度,同时保持前向传播的精准范数对齐,确保视觉编码器从训练初期就获得有效监督。
5.2 EXPERIMENTAL SETUP(实验设置)
为保证实验的可复现性和结果的说服力,作者基于LLaVA-1.5经典架构搭建实验环境,统一设置训练流程、超参数和评估基准,核心配置如下:
- 模型架构
基础语言模型(LLM)选用Llama-3.2-3B-Instruct和Qwen2.5-7B-Instruct两种骨干,视觉编码器均为SigLIP-SO400M-Patch14-384,覆盖不同量级、不同设计的LLM以验证方法的通用性。 - 训练流程与超参数
采用两阶段统一训练协议,均使用余弦学习率调度器(预热比0.03)、权重衰减设为0,随机种子固定为42;所有图像统一缩放到384×384,未使用动态高分辨率策略:- 阶段1:在LLaVA-558K数据集做1轮特征对齐预训练,学习率1e-3,单设备批次2,梯度累积2步(全局批次256);
- 阶段2:在LLaVA-NeXT数据集做1轮全模型指令调优,LLM学习率1e-5、视觉编码器2e-6,单设备批次1,梯度累积4步(全局批次128)。
- 评估基准与解码策略
采用贪心解码,从多模态和纯文本两大维度全面评估模型性能:- 多模态任务:MMBench、MM-Star、POPE、SEED-Bench-2、OCRBench、ScienceQA、AI2D;
- 纯文本任务:HellaSwag(常识推理)、MMLU(多任务语言理解),验证方法是否能实现模型整体能力提升而非仅优化多模态性能。
5.3 RESULTS AND ANALYSIS(结果与分析)
通过主性能对比、消融实验、诊断分析三个维度,验证所提方法的有效性、关键设计的必要性,以及方法与“缓解范数失衡-消除非对称更新”核心理论的一致性,是实验部分的核心结果呈现:
5.3.1 MAIN PERFORMANCE GAINS(主性能提升)
不同LLM骨干对方法的响应存在差异,但加入GWC的范数对齐方法均能实现多模态+纯文本任务的综合性能提升,核心结论:
- Llama-3.2:简单范数对齐(无GWC)即可实现全任务稳健提升,多模态任务(如MM-Star+3.47、SEED-Bench-2+4.40)和纯文本任务(MMLU+8.02)均有显著增益;
- Qwen2.5:朴素范数对齐(无GWC)因梯度消失问题,多模态任务性能衰退(如MMBench-1.20),仅纯文本任务小幅提升;加入GWC后解决梯度消失,所有多模态任务均实现增益(如MMBench+0.86、OCRBench+2.40),纯文本任务也同步优化(MMLU+0.72);
- 注意力可视化验证:基线模型的文本-图像注意力分散且无聚焦(如错误集中在图像底部区域),而范数对齐模型的注意力能精准收敛到与文本查询语义相关的视觉区域,证明方法有效恢复了有意义的跨模态注意力,实现真正的特征融合。
同时作者指出,GWC机制存在梯度振荡的潜在风险,探索更稳定的范数压缩策略是未来的研究方向。
5.3.2 ABLATION STUDY: THE CRITICAL ROLE OF INITIALIZATION(消融实验:初始化的关键性)
为孤立针对性初始化策略的作用,对比默认初始化(gain=1、bias=0) 和作者提出的初始化策略,分析LLaVA阶段1预训练后新增LayerNorm层的参数变化,核心结果:
- 默认初始化:层参数几乎无更新(如gain的平均绝对值仍≈0.96),说明优化过程未有效启动,仅添加LayerNorm层无实际作用;
- 作者提出的初始化:层参数出现有意义的更新(如gain的L2范数从初始极小值变为2.2812),证明针对性初始化是让参数进入梯度丰富区域的必要条件,是方法生效的核心设计之一。
5.3.3 DIAGNOSTIC ANALYSIS: VERIFYING THE MECHANISM OF IMPROVEMENT(诊断分析:验证改进机制)
分析全训练(阶段2)后模型的内部状态,对比基线模型与范数对齐模型的层间L2范数、层间余弦相似度两个核心指标,验证方法通过修正静态范数失衡→缓解非对称更新→提升下游性能的核心机制,结论:
- 层间L2范数:范数对齐模型从初始层就实现视觉与文本token的范数全局调和,且该对齐效果贯穿整个网络深度;基线模型则存在持续且显著的范数分歧;
- 层间余弦相似度(更新速率代理):范数对齐模型的视觉与文本token更新速率同步性显著提升,视觉token的表征惯性被有效缓解;基线模型的视觉token余弦相似度持续偏高,更新速率远慢于文本token,非对称更新现象严重。
核心结论:修正静态范数失衡能有效减轻Pre-Norm MLLMs的非对称更新动态,这是下游性能提升的根本原因。
6 CONCLUSION
本研究的分析揭示了预归一化多模态大语言模型中一种此前未被发现的关键动态特征——非对称更新。我们已对该动态特征完成理论形式化推导与实证验证,证实其是视觉标记与文本标记之间存在严重范数差异所导致的直接结果。分析表明,这一动态特征具体表现为高范数视觉标记产生表征惯性,从架构层面根本上损害了跨模态融合效果。正是基于对这一机制的深度剖析,我们提出了针对性的解决方案:通过单个融合全局权重补偿机制的层归一化层,实现范数强制对齐。实验结果显示,模型在多模态任务中取得了显著的性能提升,尤为关键的是,在纯文本任务上的表现也同步改善,这为我们的核心分析提供了强有力的实证佐证,印证了解决这一动态失衡问题能够充分释放出模型的全部性能潜力。
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 18
 0
- 0


 已为社区贡献1条内容

所有评论(0)