登录社区云,与社区用户共同成长
邀请您加入社区
系列:Spring AI 企业级开发实战项目名称:EduAgentX AI Ecosystem Platform技术栈:Spring Boot 3.5 + Spring Cloud Alibaba + Spring AI + DeepSeek + Redis + PostgreSQL + PGVector + MySQL + Vue3 + Docker + Kubernetes难度:⭐⭐⭐⭐⭐适合
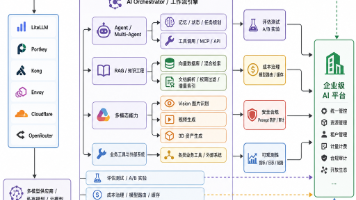
本文你将学到如何从 21 篇文章中看出 Spring AI 企业级落地的完整知识体系如何按“基础能力 -> 知识工程 -> 编排平台 -> 生产治理 -> 场景扩展 -> 平台入口”的顺序阅读每篇文章解决的核心问题、适合的业务场景和关键技术点Spring AI 在 Agent、RAG、多模态、工作流、安全、观测、行业方案和 AI Gateway 中的架构位置如何把这套文章沉淀为团队内部 AI 应用
「从基本原理出发」在接触RAG的过程中,我发现很多人把它理解成一个“检索+生成”的简单组合:先查点资料,再让大模型照着回答。
LLM是一个不可靠的“函数”,需要用可靠的代码结构把它“框”住。它不相信AI的自主规划能力,而是相信人类工程师的架构设计能力。在这种模式下,程序路径是显式定义的A→B→C流程,控制权100%在代码侧。开发者决定何时调用LLM、Prompt是什么、输出怎么解析、解析失败怎么重试。Spring AI Alibaba正是这种设计理念的代表。它提供基于Graph的图编排能力,通过声明式的API定义节点和边
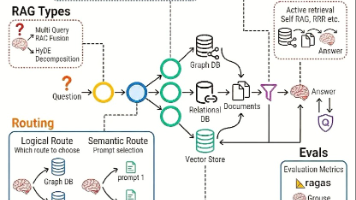
Spring AI 学习篇(八)| RAG效果优化第一弹:检索优化
Spring AI 学习篇(三)| 大模型API对接的统一范式
# 二、能耗经济学的核心挑战### 2.1 边际成本的指数上升推理时计算带来的不仅是成本绝对值的上升,更严重的是边际成本曲线的恶化。只有那些能在"用算力换智能"和"用效率换成本"之间找到平衡点的团队,才能在推理时计算的新时代立于不败之地。:超低延迟推理使实时深度推理成为可能### 5.3 架构层面的革新一些前沿架构正在实验"分布式推理":- 思维链的不同部分由不同模型协作完成- 边缘设备分担部分推
AI 服务网关将传统微服务网关的"请求级调度"升级为"Token 级调度",核心在于三件事:基于 Token 消耗的令牌桶限流、基于业务语义的供应商路由、以及预估-修正闭环的计量模型。落地时需重点关注 Token 预估精度(建议偏差控制在 20% 以内)、供应商切换的格式适配(必须覆盖 System Message 和 Function Calling 差异)、以及分布式令牌桶的一致性方案(单实例
标题:性能测试环境差异导致的"假优化"问题及解决方案 摘要:文章揭示了性能测试中常见的环境差异陷阱,包括硬件配置(如SSD与机械盘)、数据量级(小表与大表)、容器资源限制(Kubernetes CPU配额)和网络拓扑(同机房与跨地域)等因素导致的测试失真现象。作者指出这些差异会让压测结果变得不可靠,甚至产生误导性的优化结论。针对这些问题,文章提出了标准化解决方案:通过容器化统一硬件环境、复制生产数
Spring Boot 4.4 是在 Spring Framework 6.2 基础上构建的,它不仅继承了 Spring Boot 一贯的约定优于配置理念,还引入了许多现代化的特性,特别是在云原生、可观测性和开发体验方面有了显著提升。Spring Boot 4.4 是一个值得升级的版本,它带来的新特性可以帮助我们构建更现代化、更高效的应用程序。逐步迁移:先在非核心服务上试用新版本充分利用原生镜像:
ChatClient 是 Spring AI 框架中最高级、最推荐使用的统一交互入口。如果说底层的 ChatModel 像是需要自己处理各种细节的“手动挡”,那么 ChatClient 就是一台功能丰富、开箱即用的“智能点餐机”。它采用构建者模式(Builder)和流式 API(Fluent API),通过链式调用极大地简化了代码,并且内置了对系统提示词、对话记忆、RAG(检索增强生成)以及函数调
主要实现adviseCall adviseStream 方法。在调用LLM前后做一些事情。** 在多个Advisor中传递内容**可使用context中put 和 get 的方法来传递。/// 在clientRequest中放处理后的结果信息/// 获取到其他Advisor拦截器中所赋值的内容。
当前程序员平均日消耗token 突破300万,实现token自由几乎成了每个程序员的梦想。基于此,飞算JavaAI又出手了,就是被程序员称作“最符合中国程序员的AI编程工具”,推出了专业版,直击开发者痛点——无限token随心用
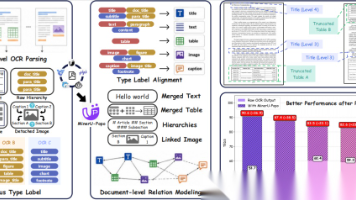
MinerU-Popo:面向 RAG 的文档级 OCR 后处理框架
#MCP它是通过网络上面的一些通用信息,以及垂直业务领域的一些信息某个位置同边有什么好吃的,我自己业务系统当中的一些信息,他肯定是不知道的,我们就需要通过function-Call,或者叫做TOOlS来进行实现,这样呢就可以让大模型,间接的去调用我们系统当中的方法,从而呢去查询第三方的天气接口,或者说昵去查询地图信息,去查询我们自己业务的一些信息,想要基础大模型具备这个功能呢,首先我们得告诉大模型
本文介绍了基于OpenTelemetry的云原生可观测性解决方案。通过Spring Boot官方starter集成OpenTelemetry,实现Metrics、Traces、Logs三合一监控。采用Prometheus收集指标数据、Jaeger处理分布式追踪、Loki聚合日志,构建"PLGJ"黄金组合。文章详细说明了pom依赖配置、OTLP协议对接方式、指标采集实现以及日志A
本文基于SSM框架和MySQL数据库,设计并实现了一款微信小程序外卖点餐系统。系统包含管理员和用户两个角色:管理员可管理用户信息、菜品分类、订单及评价等;用户可实现菜品浏览、收藏、购物车及订单管理等功能。采用Java开发后台,结合微信开发者工具,系统具有操作简便、功能完善的特点,有效提升了外卖点餐的管理效率和用户体验。研究表明,该系统实现了餐饮管理的信息化和规范化,具有一定的实用价值。
当对话超过一定轮数或Token阈值时,调用LLM把旧对话压缩成一段摘要,后续请求携带“历史摘要 + 最近几轮对话”。请将以下对话压缩为不超过200字的摘要,必须保留:1. 用户提到的所有数字类信息(预算、价格、数量)2. 用户提到的所有实体名称(产品名、人名)3. 用户的明确意图或偏好对话内容:{old_messages}"""return llm(prompt) # 调用一次LLM生成摘要# 后
AI 推理监控的核心是将"请求成功"细化为"请求成功且输出可用且成本合理"。本文的四层指标体系为:基础设施(GPU/显存)→ 服务可用性(延迟/TTFT)→ 推理质量(截断/格式/幻觉)→ 成本效率(Token/费用)。SLO 建议设定三个核心目标:P99 延迟 < 30s、TTFT P95 < 5s、输出截断率 < 5%。落地时需重点关注 Token 计量的跨模型一致性,以及质量检测的异步化实现
Spring Boot 配置加密在 K8s 的安全管理指南 摘要 本文针对 Spring Boot 应用在 Kubernetes 环境中的配置加密问题,揭示了四种典型密钥管理风险: 加密密钥硬编码导致镜像泄密 环境变量注入密钥被进程查看暴露 依赖外部服务导致启动失败 ConfigMap 容量限制问题 提出四种解决方案: K8s Secret + Init Container:密钥仅存在于初始化容器
这篇面向想转向大模型方向的程序员和计算机专业学生,但不会把“AI大模型就业:普通程序员如何抓住下一轮机会”写成概念清单。我会按务实、犀利、面向就业的技术教程的思路,把它放到真实开发、学习路线和求职准备里看,顺便讲几个容易忽略的取舍。这次我会从“从求职作品集角度切入,重点写可展示成果”展开,换一组场景和例子来讲。回到“AI大模型就业:普通程序员如何抓住下一轮机会”这个主题,最重要的不是把名词背全,而
pythondef compress_context(long_text, target_tokens=4000): """用小模型压缩长上下文""" prompt = f"""请将以下文本压缩到 {target_tokens} tokens 以内,保留关键信息: {long_text}压缩结果:""" return small_llm_call(prompt, max_tokens=target
LLM 推理延迟监控的核心是建立 Token 级指标体系,TTFT 和 ITL 是比端到端延迟更有价值的观测维度。TTFT 升高指向 Prefill 瓶颈,ITL 升高指向 Decode 瓶颈,GPU 资源指标帮助定位根因。落地时建议先实现 TTFT 和 ITL 两个核心指标的采集和告警,再逐步补充 GPU 资源指标和全链路 Trace。指标基数和存储成本是需要持续优化的维度,采样策略应根据业务规
AI 辅助降级不是替代传统规则,而是在规则之上增加一层弹性决策能力。规则负责兜底(硬性阈值不可突破),AI 负责在阈值之内的灰色地带做精细化调整。落地时建议先实现特征提取和降级执行两个基础模块,用规则引擎做初始决策,再逐步引入 AI 推理引擎。模型训练需要积累足够的历史故障数据,冷启动阶段可以用模拟数据预训练。核心指标是降级决策的准确率和恢复时间,而非模型本身的精度。
Spring Boot 3.0 的升级价值取决于业务场景。I/O 密集型应用(大量数据库查询、外部 API 调用)是虚拟线程的最大受益者,CPU 密集型应用收益有限。云原生和 Serverless 场景对原生编译的启动速度和内存占用敏感,传统部署场景则不必急于迁移。升级路径建议分三步:先完成 Jakarta 命名空间迁移和 JDK 17 升级,再启用虚拟线程并排查 Pin 问题,最后在非核心服务上
如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。学AI大模型,就是冲刺高薪的最优解!零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序
Spring Integration是Spring生态系统中的企业应用集成(EAI)框架,基于消息驱动架构实现系统间通信。核心概念包括Message(消息)、MessageChannel(消息通道)和MessageEndpoint(消息端点)。框架提供了多种企业集成模式实现,如转换器(Transformer)、过滤器(Filter)、路由器(Router)等,以及文件、HTTP、JMS等协议适配器
基于SpringBoot和Vue框架,设计与实现了一款功能丰富的新能源汽车销售管理系统。通过详细分析市场需求和现有问题,结合现代软件开发技术,实现了用户管理、汽车信息管理、汽车预定管理、取消预定管理、购车信息管理、售后反馈管理、系统管理、通知公告管理、资源管理、权限管理等多个模块的开发。在设计过程中,采用了前后端分离开发模式,利用Vue.js框架作为前端开发技术,提升了用户体验;后端基于Sprin
三个核心维度,落地三套生产级解决方案:RAG文档智能分片与重叠度调优、Spring AI + Elasticsearch深度混合检索、AI接口限流熔断与全链路监控告警,补齐RAG项目从Demo到商用的最后短板。本文三套方案分别解决了RAG准确率上限、检索适配性、服务稳定性三大核心问题,代码零侵入、可直接上线,是当前Spring AI RAG项目的标准生产优化方案。纯全文检索无法理解模糊语义与上下文
大模型叙事逻辑已经出现了极为明显的变化。过去三年,大家更会关注:谁更会回答问题,谁回答得更聪明、准确、快速?但随着一系列Agent产品的涌现,大模型也开始向真实世界的复杂任务发起冲锋。现在的问题变成:谁能真正承担任务?如果说 GLM-4.5 是“会推理、会写代码的模型”,那么 GLM-5 的野心更直接——成为复杂系统里的执行者。
本文介绍了Rerank(重排序)技术在RAG系统中的使用方法和价值。Rerank通过两阶段检索架构(粗排+精排)提升检索精度,解决传统向量检索的局限性,如语义相似度不足、排序质量不佳和上下文理解缺失等问题。文章详细说明了Rerank的工作原理、配置方式、核心组件(包括DashScopeRerankModel和RetrievalRerankAdvisor)以及完整的代码示例。Rerank通过专业化模
本研究旨在通过开发一款中医美容养生小程序,并为用户提供随时随地的中医美容养生指导,以此传承中医文化并适应现代社会需求。该系统利用微信这一中国最广泛使用的社交平台作为载体,通过小程序的形式为中医美容养生提供了新的传播与应用平台。系统的前端开发采用了微信小程序框架,使用WXML、WXSS和JS文件构建直观易用的界面,并集成丰富的基础和扩展组件,实现了养生知识库、社区交流、美容资讯、产品商城等核心功能模