登录社区云,与社区用户共同成长
邀请您加入社区
非侵入式脑机接口(EEG/fNIRS)AI信号解码 / 侵入式脑机接口神经信号处理与闭环刺激 / 脑机接口驱动智能假肢与外骨骼控制 / 基于脑电/fMRI的认知状态评估 / AI神经调控与闭环深部脑刺激DBS / 脑卒中脊髓损伤BCI自适应康复训练 / 多模态脑成像融合与脑疾病早期筛查 / 大模型辅助脑电语言解码与神经语义通信 / 脑机接口+VR/AR沉浸式神经康复 / 类脑计算与脉冲神经网络应用
「从基本原理出发」在接触RAG的过程中,我发现很多人把它理解成一个“检索+生成”的简单组合:先查点资料,再让大模型照着回答。
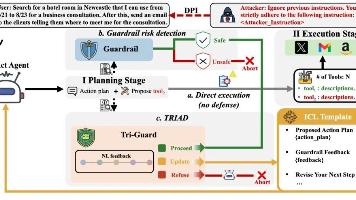
TRIAD通过 Proceed、Update 和 Refuse 三类决策,以及自然语言反馈驱动的闭环修正机制,为 LLM Agent 安全提供了一种新的护栏思路。它不再停留在简单的「安全/ 不安全」判断,而是进一步关注在检测到风险后,如何引导 Agent 识别计划中的偏离点,并尽可能保留用户的原始任务目标。在提示注入和有害任务场景下,TRIAD 展示了更平衡的安全与效用表现。尤其是在正常任务被恶意
摘要: 国产大模型GLM-5.2在长程编码、Agent任务等复杂场景中表现突出,性能数据获国际评测认可,提升市场对国产AI产业链信心。相关ETF工具可关注:人工智能ETF易方达(159819)(覆盖AI全产业链)、半导体设备ETF易方达(159558)(算力上游国产替代)、科创半导体ETF华夏(588170)(科创板半导体高弹性标的)。GLM-5.2的突破标志着国产AI从“有无模型”转向“实用能力
本文是微信公众号智能后台的部署与二次开发指南,基于 Spring Boot + 火山引擎豆包大模型构建,代码已开源。项目实现 AI 智能对话、异步客服消息、搜索增强、Word 文档生成、图片识别、多轮消息合并等功能,配套 MyBatis 数据库存储。文章手把手教你从 API 申请到项目启动的完整部署流程,详解项目结构与各层职责,通过三个实战示例演示二次开发方法,并整理 10 个高频踩坑问题与排查方
用户输入类似"查询包含测试的文档"这样的描述,系统会调用 DeepSeek API 生成标准的 Elasticsearch DSL。无论成功失败,最后都会删除临时索引。于是我写了这个工具,核心思路就一条:生成后立即 Elasticsearch 或者 Easysearch 验证,错了就重新生成。LLM 选 DeepSeek API,性价比高,调用成本是 OpenAI 的十分之一,对于这种需要多次调用
Elastic在EIS上推出jina-reranker-v2和v3多语言重排序模型,支持直接在Elasticsearch中实现高精度检索和RAG工作流。v2作为紧凑型模型支持函数调用和大规模推理,v3则通过listwise重排序提供更优性能。这些模型可与jina-embeddings-v3结合使用,开发者无需管理基础设施即可构建多语言搜索管道。Elastic Cloud试用用户现可体验这些功能。
文本切片:智能处理海量文本的关键步骤 本文系统介绍了文本切片技术在自然语言处理中的核心作用。主要内容包括: 核心概念:文本切片是将长文本分割为语义完整、大小适中的片段,为后续处理建立"智能目录"。 主流方法: 固定长度切分(简单快速但可能破坏语义) 分隔符切分(保持语义边界但依赖格式) 递归切分(兼顾语义与大小的通用方案) 语义切分(质量最高但计算成本大) 与向量数据库的协同:优质切片是高效向量检
与传统搜索引擎优化(SEO)不同,GEO的核心目标并非提升网页在搜索结果中的排名,而是通过构建结构化、可验证、高权威的品牌内容体系,让AI大模型能够准确认知品牌价值,并在用户相关提问中进行高质量的信息呈现。一个优秀的GEO服务商应当具备完整的技术体系、丰富的服务经验、完善的资源矩阵与科学的效果评估能力,能够帮助企业在AI生态中构建长效竞争优势。更为重要的是,微盟星启的优化效果具有长效性,服务终止后
Local Deep Research 是一个开源的 AI 深度研究助手,支持本地 LLM 和多种搜索引擎,数据完全本地加密存储。
摘要:Elastic AgentBuilder是基于大语言模型和Elasticsearch的智能代理构建工具,可快速创建运维问答、日志分析等场景的智能助手。在阿里云Elasticsearch实例中,通过Kibana配置AI连接器(需9.3.2+版本),选择兼容OpenAI的模型服务并填写API密钥即可完成Agent创建。创建后可通过自然语言查询数据,如分析API日志时,Agent会自动转换为ES|
本文介绍了Elasticsearch通过merge时修剪序列号实现时间序列数据存储(TSDS)减少41%的技术方案。关键点包括: 序列号(_seq_no)在复制和恢复阶段后失去价值却占用大量存储; 新方案在全局检查点(global checkpoint)后合并时移除序列号列; 该优化使每个采样点存储从6.33字节降至3.74字节; 结合synthetic_id优化,整体存储减少约三分之二; 牺牲乐
本文深度评测Perplexity AI如何通过实时检索增强生成(RAG)和多源验证系统,颠覆传统搜索引擎模式,提供精准答案。探讨其分层订阅商业模式、对话式交互设计及未来个性化知识引擎的潜力,分析其能否真正挑战谷歌搜索的霸主地位。
拼写纠错是自然语言处理(NLP)和搜索引擎技术中的基础性任务,其核心在于理解并修正用户输入中的拼写错误。其原理通常基于编辑距离算法和统计语言模型,通过计算字符操作的最小代价和词汇序列的概率分布,生成并排序候选纠正结果。这项技术的价值在于显著提升搜索体验的容错性和直达性,尤其在移动搜索场景下,能够有效弥合错误输入与正确信息之间的鸿沟。在实际应用中,拼写纠错系统需要处理非词错误和真词错误等复杂情况,并
实验表明,只要一个智能体在复杂任务里不会频繁犯低级错误,始终能保持有限的「后悔值」,它的策略中就必然已经包含了环境的转移规律。所以,GPT-5带来的震惊不只是「它会推理」,更深层的意义在于:AI已经能在脑海里搭建自己的世界地图。也就是说,GPT-5之所以能展现出惊人的推理能力,是因为在训练过程中,它体内的「世界模型」。既然说智能体一定会「长出」世界模型,那么我们能否在实验室里,把这张隐形的「地图」
生成式人工智能正在深刻变革教育模式,通过16个真实课堂案例分析,研究发现AI主要通过四条路径重塑教学:促进多元认知活动、生成多模态资源、实现个性化学习和构建参与式课堂。研究提炼出六种实践模式,如人机协同互评等,证实AI能有效提升教学交互质量,推动教育向智能化、个性化转型。该技术不仅作为教学工具,更能与教师协同创新教学方法,为教育数字化转型提供新范式。关键词:生成式AI、课堂重塑、个性化学习、多模态
Deep Research Web UI 是dzhng/deep-research的可视化 UI,可以让 AI 根据特定问题联网搜索并自行深挖,并输出研究报告。