第8(T10)周 数据增强
- **🍨 本文为[🔗365天深度学习训练营](https://mp.weixin.qq.com/s/o-DaK6aQQLkJ8uE4YX1p3Q) 中的学习记录博客**
- **🍖 原作者:[K同学啊](https://mtyjkh.blog.csdn.net/)**
文章目录
概要
通过数据增强用少量数据达到非常非常棒的识别准确率
整体架构流程
方法一(把数据增强当成模型的第一层)
输入图片
↓
data_augmentation层(第1层)→ 随机翻转、旋转、缩放
↓
Conv2D层(第2层)→ 卷积提取特征
↓
MaxPooling2D层(第3层)→ 池化
↓
... 更多层
↓
输出结果
代码运行
1. 设置GPU
import matplotlib.pyplot as plt
import numpy as np
#隐藏警告
import warnings
warnings.filterwarnings('ignore')

from tensorflow.keras import layers
import tensorflow as tf
gpus = tf.config.list_physical_devices("GPU")

if gpus:
    tf.config.experimental.set_memory_growth(gpus[0], True)  #设置GPU显存用量按需使用
    tf.config.set_visible_devices([gpus[0]],"GPU")

# 打印显卡信息,确认GPU可用
print(gpus)
2. 加载数据
data_dir   = "/home/xxx/34-data"
img_height = 224
img_width  = 224
batch_size = 32

train_ds = tf.keras.preprocessing.image_dataset_from_directory(
    data_dir,
    validation_split=0.3,
    subset="training",
    seed=12,
    image_size=(img_height, img_width),
    batch_size=batch_size)
val_ds = tf.keras.preprocessing.image_dataset_from_directory(
    data_dir,
    validation_split=0.3,
    subset="validation",
    seed=12,
    image_size=(img_height, img_width),
    batch_size=batch_size)
将验证集中20%取作为测试集
val_batches = tf.data.experimental.cardinality(val_ds)
test_ds     = val_ds.take(val_batches // 5)
val_ds      = val_ds.skip(val_batches // 5)

print('Number of validation batches: %d' % tf.data.experimental.cardinality(val_ds))
print('Number of test batches: %d' % tf.data.experimental.cardinality(test_ds))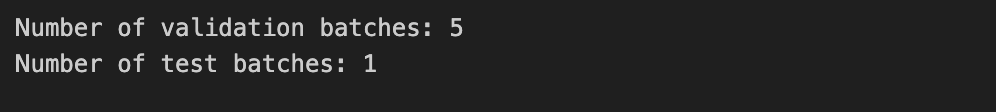
class_names = train_ds.class_names
print(class_names)
AUTOTUNE = tf.data.AUTOTUNE

# 原始图片的像素值范围是0-255(RGB颜色值),归一化
def preprocess_image(image,label):
    return (image/255.0,label)

# 应用归一化
train_ds = train_ds.map(preprocess_image, num_parallel_calls=AUTOTUNE)
val_ds   = val_ds.map(preprocess_image, num_parallel_calls=AUTOTUNE)
test_ds  = test_ds.map(preprocess_image, num_parallel_calls=AUTOTUNE)

train_ds = train_ds.cache().prefetch(buffer_size=AUTOTUNE)
val_ds   = val_ds.cache().prefetch(buffer_size=AUTOTUNE)

# 图形的宽为15高为10
plt.figure(figsize=(15, 10))

# take(1)从训练集中只取1批数据
# (5, 8, i + 1) 5行,每行8个图片,当前是第几个位置

for images, labels in train_ds.take(1):
    for i in range(8):

        ax = plt.subplot(5, 8, i + 1)
        plt.imshow(images[i])
        plt.title(class_names[labels[i]])

        plt.axis("off")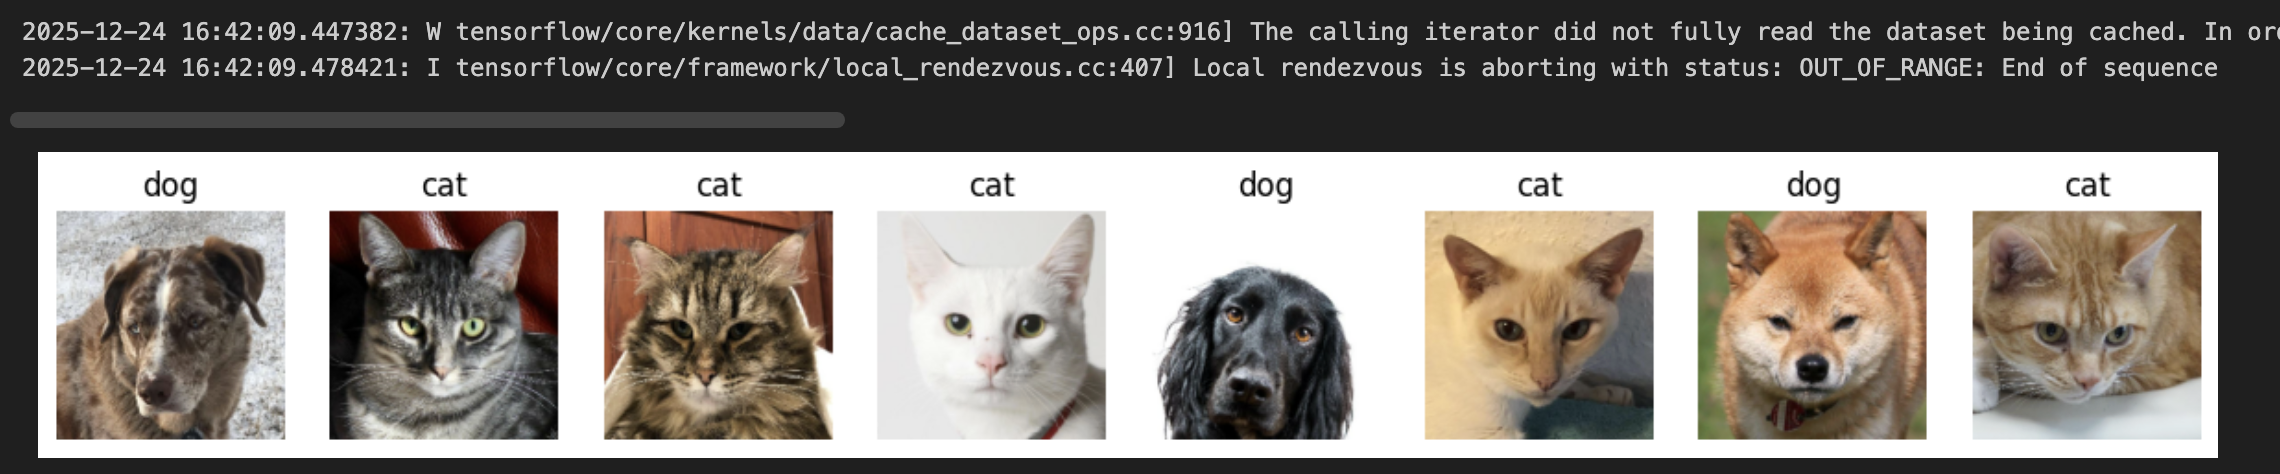
3.数据增强
可以使用 tf.keras.layers.experimental.preprocessing.RandomFlip 与 tf.keras.layers.experimental.preprocessing.RandomRotation 进行数据增强
tf.keras.layers.experimental.preprocessing.RandomFlip:水平和垂直随机翻转每个图像。tf.keras.layers.experimental.preprocessing.RandomRotation:随机旋转每个图像
# 第一个层表示进行随机的水平和垂直翻转,而第二个层表示按照 0.2 的弧度值进行随机旋转
data_augmentation = tf.keras.Sequential([
    tf.keras.layers.RandomFlip("horizontal_and_vertical"),
    tf.keras.layers.RandomRotation(0.2),
])
# 从一批图片中选一张
image = tf.expand_dims(images[i], 0)

# 创建一个画布
plt.figure(figsize=(8, 8))

# 循环9次
for i in range(9):
    # 对图片做随机变换
    augmented_image = data_augmentation(image)

    # 放到3×3网格中的某个位置
    ax = plt.subplot(3, 3, i + 1)

    # 显示变换后的图片
    plt.imshow(augmented_image[0])

    # 不显示坐标轴
    plt.axis("off")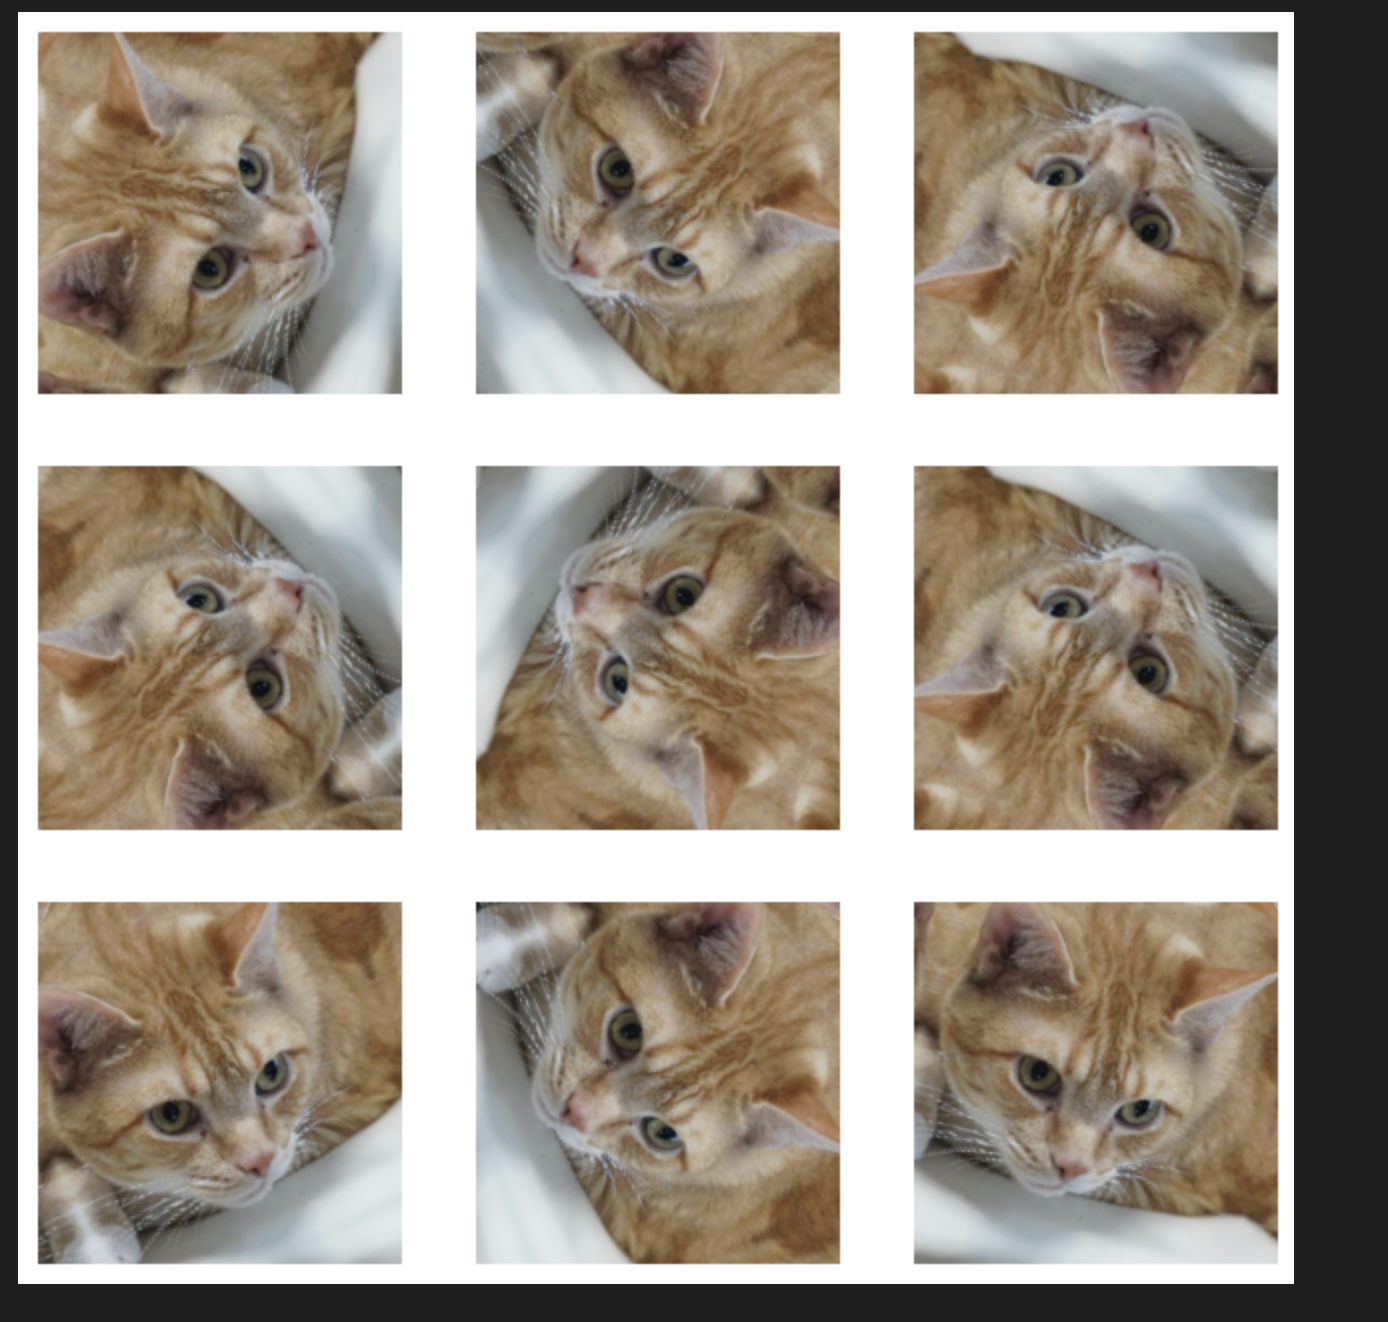
3.增强方式
方法一:将其嵌入到model中
model = tf.keras.Sequential([
    data_augmentation,              # 数据增强层
    layers.Conv2D(16, 3, padding='same', activation='relu'),
    layers.MaxPooling2D(),
    # ... 更多层
])
注意:只有在模型训练时(Model.fit)才会进行增强,在模型评估(Model.evaluate)以及预测(Model.predict)时并不会进行增强操作。
方法二:在Dataset数据集中进行数据增强
batch_size = 32
AUTOTUNE = tf.data.AUTOTUNE

def prepare(ds):
    ds = ds.map(lambda x, y: (data_augmentation(x, training=True), y), num_parallel_calls=AUTOTUNE)
    return ds

train_ds = prepare(train_ds)
4. 训练模型
model = tf.keras.Sequential([
  layers.Conv2D(16, 3, padding='same', activation='relu'),
  layers.MaxPooling2D(),
  layers.Conv2D(32, 3, padding='same', activation='relu'),
  layers.MaxPooling2D(),
  layers.Conv2D(64, 3, padding='same', activation='relu'),
  layers.MaxPooling2D(),
  layers.Flatten(),
  layers.Dense(128, activation='relu'),
  layers.Dense(len(class_names))
])
model.compile(optimizer='adam',
              loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True),
              metrics=['accuracy'])
epochs=20
history = model.fit(
  train_ds,
  validation_data=val_ds,
  epochs=epochs
)
loss, acc = model.evaluate(test_ds)
print("Accuracy", acc)
可加入自定义增强函数
技术名词解释
AUTOTUNE = tf.data.AUTOTUNEAUTOTUNE: 让 TensorFlow 自动调整最优参数。系统会根据硬件(CPU/GPU)自动选择最佳的线程数、缓存大小等
num_parallel_calls=AUTOTUNE 并行处理,多个CPU核心同时工作
cache() - 缓存数据
prefetch() - 预取数据 GPU不用等待,训练不间断
buffer = 缓冲区 - 决定**提前准备多少批次的数据**
小结
常见的数据增强方法
1️⃣ 几何变换(改变图片的形状/位置)
✅ 旋转 (Rotation)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱 │ (转15度)
└─────┘ └─────┘
✅ 翻转 (Flip)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐈 │ (水平翻转)
└─────┘ └─────┘
✅ 缩放 (Zoom)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱 │ (放大)
└─────┘ └─────┘
✅ 平移 (Shift)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱│ (向右移)
└─────┘ └─────┘
✅ 剪切 (Shear)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱/ │ (倾斜)
└─────┘ └─────┘
2️⃣ 颜色变换(改变图片的颜色)
✅ 亮度 (Brightness)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱✨│ (变亮)
└─────┘ └─────┘
✅ 对比度 (Contrast) ← 就是这段代码在做的!
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱! │ (对比强烈)
└─────┘ └─────┘
✅ 饱和度 (Saturation)
┌─────┐ ┌─────┐
│ 🐱🎨│ → │ 🐱📝│ (颜色变淡)
└─────┘ └─────┘
✅ 色调 (Hue)
┌─────┐ ┌─────┐
│橙猫🐱│ → │蓝猫🐱│ (改变颜色)
└─────┘ └─────┘
3️⃣ 噪声/模糊(改变图片清晰度)
✅ 添加噪声 (Noise)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱⚡│ (加噪点)
└─────┘ └─────┘
✅ 模糊 (Blur)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱? │ (模糊)
└─────┘ └─────┘
4️⃣ 裁剪/遮挡
✅ 随机裁剪 (Random Crop)
┌─────┐ ┌───┐
│ 🐱 │ → │🐱 │ (裁掉一部分)
└─────┘ └───┘
✅ 随机擦除 (Random Erasing)
┌─────┐ ┌─────┐
│ 🐱 │ → │ 🐱█ │ (遮住一块)
└─────┘ └─────┘
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 30
 0
- 0


 已为社区贡献1条内容

所有评论(0)