机器学习必备公式之Softmax函数
第一部分:介绍Softmax函数
Softmax 函数 是一种常用的归一化函数,通常用于多分类问题中。它将一个 K 维的实值向量转换为一个 K 维的概率分布,使得每个元素的值在 [0, 1] 之间,且所有元素的和为 1。
公式:

其中:
 是输入向量的第 i 个元素;
-
 是向量的维度;
-
 是
 的指数;
- 分母是所有元素的指数和。
作用:
- 将输入向量转换为概率分布,便于分类问题中使用。
- 通过指数运算,放大了不同元素之间的差异。
第二部分:Softmax 函数的推导过程
Softmax 函数的推导过程可以从概率模型和最大似然估计的角度来理解。以下是详细的推导过程:
2.1 问题背景
在多分类问题中,我们需要将一个 K 维的实值向量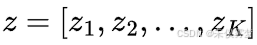 转换为一个概率分布
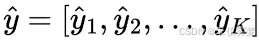 ,其中:
- 每个
 表示属于第
 类的概率;
- 满足
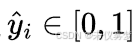 且 。
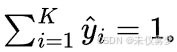
我们希望找到一种映射函数(即 Softmax 函数),能够实现这一转换。
2.2 指数变换
为了将实值向量 转换为概率分布,我们可以利用指数函数的性质:
- 指数函数
 确保输出为正数;
- 指数函数的单调性可以保留输入向量中的相对大小关系。
因此,我们首先对每个元素进行指数变换:
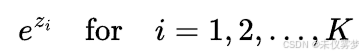
2.3.归一化
为了满足概率分布的性质(和为 1),我们需要对指数变换后的结果进行归一化。归一化方法是将每个元素除以所有元素的和:
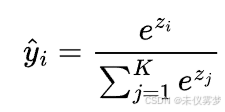
这就是 Softmax 函数的最终形式。
2.4. 最大似然估计的视角
从概率模型的角度,Softmax 函数可以通过最大似然估计(Maximum Likelihood Estimation, MLE)推导出来。
假设我们有一个多分类模型,模型的输出 表示第 类的预测概率。模型的参数是根据训练数据,通过最大化似然函数来优化的。
(a) 似然函数
对于样本  ,假设其真实标签为第
 类(即
 ),则模型的似然函数为:
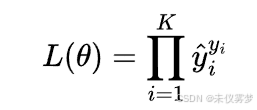
其中:
-
 是真实标签的 one-hot 编码(
 ,其余
 );
-
 是模型的预测概率。
(b) 对数似然函数
为了简化计算,我们取对数似然函数:
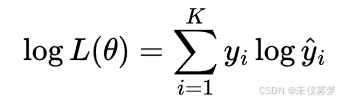
由于真实标签是 one-hot 编码,上式简化为:
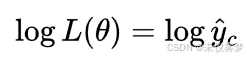
(c) 最大化对数似然
为了使对数似然最大化,我们需要使 最大化。根据 Softmax 函数的定义:
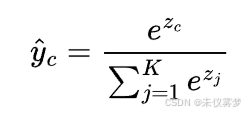
因此,最大化 等价于最大化
 相对于其他
 的值。
这一过程可以通过优化交叉熵损失函数(Cross-Entropy Loss)来实现。
总结
Softmax 函数的推导可以从以下两个角度理解:
- 数学角度:通过对实值向量的指数变换和归一化,将输入转换为概率分布。
- 概率模型角度:通过最大似然估计,推导出 Softmax 函数是最大化样本似然的最优形式。
Softmax 函数在多分类问题中具有广泛的应用,是机器学习和深度学习中非常重要的工具之一。
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)