解锁Transformer:开启AI新纪元的神奇架构
一、Transformer:AI 界的 “超级新贵”
在当今人工智能(AI)的璀璨星空中,Transformer 无疑是最为耀眼的明星之一。它就像是一位横空出世的超级英雄,以其独特的魅力和强大的能力,彻底颠覆了 AI 领域的传统格局,为无数的创新应用和突破奠定了坚实基础。
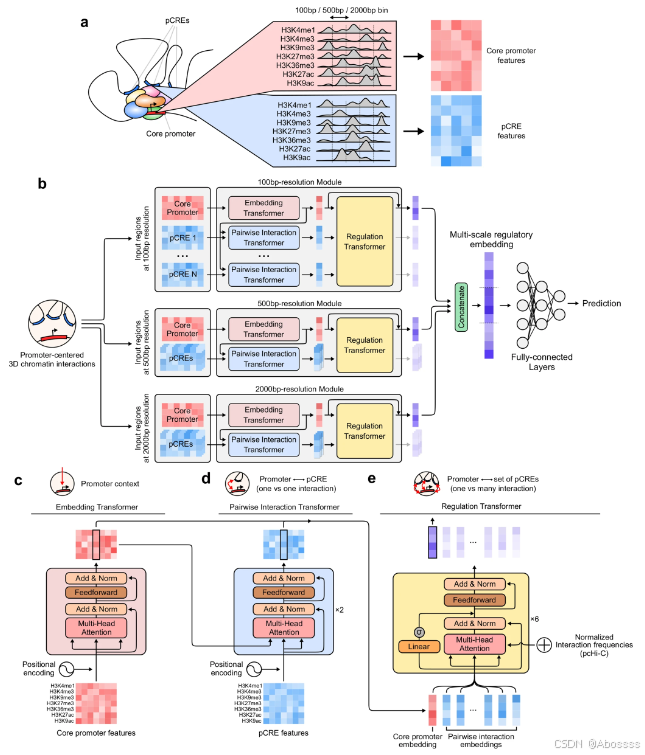
Transformer 首次亮相于 2017 年谷歌大脑团队发表的论文《Attention Is All You Need》。在这之前,循环神经网络(RNN)和卷积神经网络(CNN)在序列建模和处理领域占据着主导地位 。然而,RNN 在处理长序列时面临着梯度消失和梯度爆炸的问题,导致其难以有效捕捉长距离依赖关系;而 CNN 虽然在局部特征提取方面表现出色,但对于全局信息的把握相对较弱。
Transformer 的出现,犹如一道曙光,照亮了 AI 发展的新道路。它创新性地引入了自注意力机制(Self-Attention),摒弃了传统的循环或卷积结构,使得模型在处理序列数据时,能够直接关注到序列中的任意位置,而无需像 RNN 那样按顺序依次处理,也无需像 CNN 那样依赖局部卷积来逐步扩展感受野。这种革命性的变革,使得 Transformer 在处理长序列数据时展现出了无与伦比的优势,能够更加高效、准确地捕捉到序列中各个元素之间的复杂关系 。
举个简单的例子,在自然语言处理任务中,当我们理解一句话时,Transformer 可以同时关注到句子中的每一个单词,根据它们之间的语义关联来准确把握整句话的含义。比如对于句子 “苹果从树上掉下来,牛顿受到了启发”,Transformer 能够瞬间捕捉到 “苹果”“掉下来”“牛顿”“启发” 这些关键元素之间的联系,理解到这是在讲述牛顿发现万有引力的故事背景,而不会像传统模型那样因为长距离依赖关系而出现理解偏差。
二、Transformer 的诞生背景
在 Transformer 横空出世之前,循环神经网络(RNN)及其变体长短期记忆网络(LSTM)、门控循环单元(GRU)是处理序列数据的主流模型 。RNN 的结构设计使其能够处理具有顺序依赖关系的数据,比如在自然语言处理中,它可以按顺序逐个处理单词,利用前一个时刻的隐藏状态来处理当前时刻的输入,从而捕捉到序列中的时间依赖信息 。然而,RNN 存在着严重的梯度消失和梯度爆炸问题。当处理长序列时,随着时间步的不断增加,梯度在反向传播过程中会逐渐减小或增大,导致模型难以学习到长距离的依赖关系。例如,在分析一篇长文章的情感倾向时,文章开头的关键信息可能会因为梯度消失而无法对文章末尾的情感判断产生有效影响 。
LSTM 和 GRU 的出现,在一定程度上缓解了 RNN 的梯度问题。它们引入了门控机制,通过遗忘门、输入门和输出门来控制信息的传递和更新,从而更好地保存长期依赖信息 。以 LSTM 为例,遗忘门决定了上一时刻的记忆单元中哪些信息需要保留,输入门决定了当前输入的哪些信息需要加入到记忆单元中,输出门则决定了记忆单元中的哪些信息将被输出用于当前时刻的计算 。但是,LSTM 和 GRU 在处理长序列时仍然存在效率问题。由于它们需要按顺序依次处理每个时间步,无法充分利用现代硬件的并行计算能力,导致训练和推理速度较慢 。在处理大规模的文本数据时,这种效率低下的问题尤为突出,极大地限制了模型的应用和发展 。
而卷积神经网络(CNN)虽然在图像识别等领域取得了巨大成功,但其在处理序列数据时也存在局限性。CNN 主要通过卷积核在局部区域的滑动来提取特征,对于局部特征的提取能力很强,但对于长距离依赖关系的捕捉能力较弱 。在自然语言处理中,一个单词的含义往往需要结合句子中较远位置的其他单词来理解,CNN 难以有效地捕捉这种长距离的语义关联 。
正是在这样的背景下,Transformer 应运而生。它的出现,旨在解决传统模型在处理长序列数据时的种种不足,为序列建模带来了全新的思路和方法 。Transformer 创新性地提出了自注意力机制,使得模型在处理序列中的每个位置时,都能够直接关注到序列中的其他任意位置,从而有效地捕捉长距离依赖关系 。同时,Transformer 的结构设计使得它可以并行计算,大大提高了计算效率,能够更好地适应大规模数据的处理和训练 。
三、Transformer 核心架构剖析
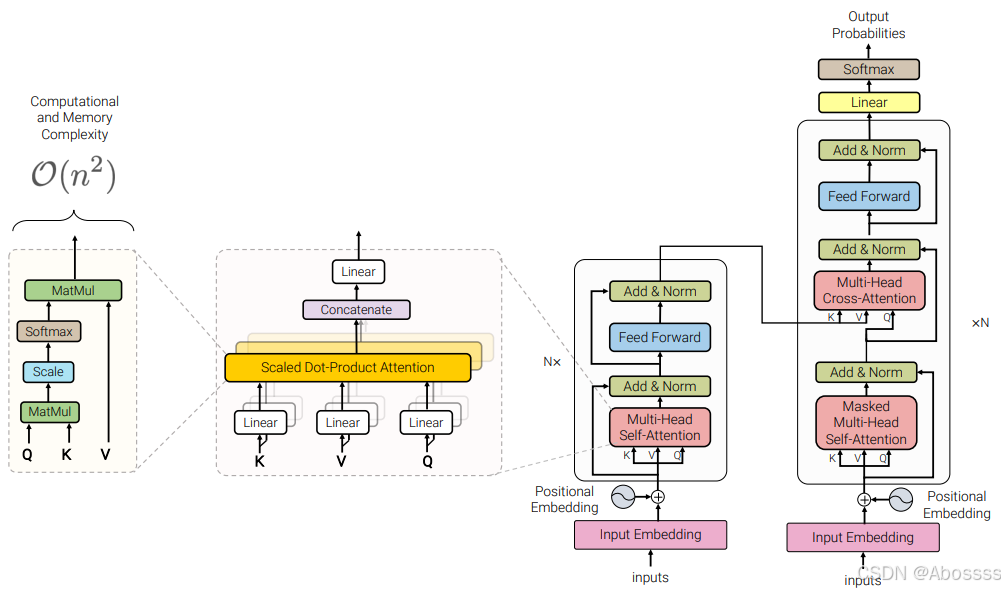
(一)编码器(Encoder)
Transformer 的编码器犹如一位智慧的信息提炼大师,它的主要职责是对输入序列进行深度加工,提取其中蕴含的关键特征和语义信息,为后续的处理奠定坚实基础 。编码器由多个相同的层堆叠而成,如同搭建一座坚固的高楼,每一层都在为整体的功能贡献着不可或缺的力量 。在机器翻译任务中,当输入一段英文句子时,编码器会对句子中的每个单词进行分析,提取出单词本身的含义以及它们之间的语法和语义关系,将这些信息整合为一个高维的特征向量表示 。
每一层编码器主要包含两个关键的子层:多头自注意力机制(Multi-Head Self-Attention)和位置前馈神经网络(Position-wise Feed-Forward Network),它们相互协作,如同精密仪器中的不同部件,共同完成对输入序列的处理 。
在进入核心子层之前,输入序列首先要经过输入嵌入(Input Embedding)与位置编码(Positional Encoding)的预处理。输入嵌入就像是一个神奇的翻译器,它将输入的离散符号(如单词)转换为连续的向量表示,使得计算机能够理解和处理这些信息 。而位置编码则是为了弥补 Transformer 模型本身无法捕捉序列顺序信息的不足而设计的 。由于 Transformer 模型完全基于注意力机制,它在处理序列时没有像循环神经网络那样的顺序性,因此需要额外的信息来标识每个元素在序列中的位置 。位置编码通过一种特殊的数学公式,将位置信息编码为向量,并与输入嵌入后的向量相加,从而让模型能够感知到序列中元素的顺序 。其数学公式如下:
PE(pos,2i)=sin(pos/100002i/dmodel)PE(pos,2i+1)=cos(pos/100002i/dmodel) PE(pos, 2i) = \sin(pos / 10000^{2i / d_{model}}) \\ PE(pos, 2i + 1) = \cos(pos / 10000^{2i / d_{model}}) PE(pos,2i)=sin(pos/100002i/dmodel)PE(pos,2i+1)=cos(pos/100002i/dmodel)
其中,pospospos表示位置,iii表示维度索引,dmodeld_{model}dmodel表示嵌入向量的维度 。通过这种方式,不同位置的元素会被赋予不同的编码,模型就可以根据这些编码来区分它们在序列中的位置 。
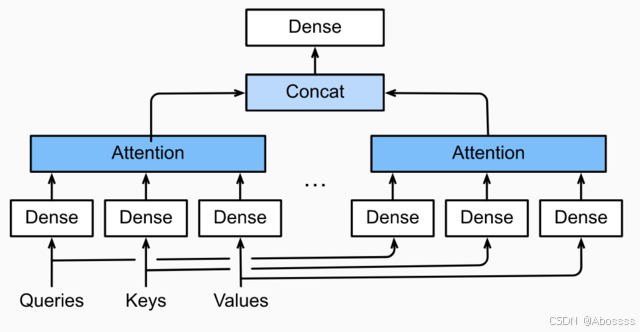
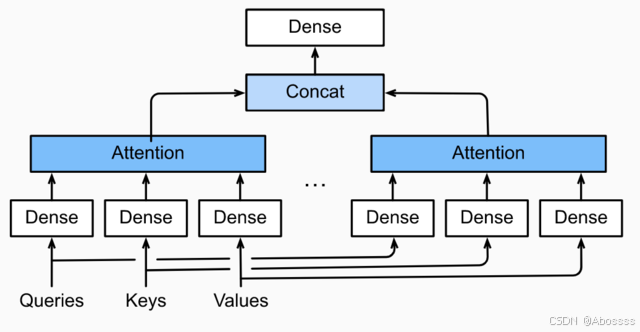
多头自注意力机制是编码器的核心组件之一,它赋予了模型强大的信息捕捉能力 。传统的注意力机制就像是一个聚光灯,在处理序列中的某个元素时,它会根据该元素与其他元素的相关性,分配不同的注意力权重,从而聚焦于序列中与当前元素相关的部分 。而多头自注意力机制则像是多个聚光灯同时工作,它将注意力机制并行化,通过多个不同的 “头”(head)来同时关注输入序列的不同部分,从而能够捕捉到更丰富、更复杂的语义关系 。
具体来说,多头自注意力机制的工作过程如下:首先,将输入向量通过线性变换分别映射为查询向量(Query, Q)、键向量(Key, K)和值向量(Value, V) 。然后,对于每个 “头”,分别计算查询向量与键向量的点积,得到注意力得分 。为了防止数值过大导致梯度不稳定,将注意力得分除以键向量维度的平方根进行缩放 。接着,通过 softmax 函数将缩放后的注意力得分转换为注意力权重,这些权重表示了当前位置与其他位置之间的相关性程度 。最后,将注意力权重与值向量相乘并求和,得到每个 “头” 的输出 。将所有 “头” 的输出拼接起来,再通过一次线性变换,就得到了多头自注意力机制的最终输出 。其数学公式为:
MultiHead(Q,K,V)=Concat(head1,...,headh)WO MultiHead(Q, K, V) = Concat(head_1,..., head_h)W^O MultiHead(Q,K,V)=Concat(head1,...,headh)WO
其中,headi=Attention(QWiQ,KWiK,VWiV)head_i = Attention(QW_i^Q, KW_i^K, VW_i^V)headi=Attention(QWiQ,KWiK,VWiV),WiQW_i^QWiQ、WiKW_i^KWiK、WiVW_i^VWiV是用于线性变换的参数矩阵,WOW^OWO是最终输出的线性变换矩阵 。
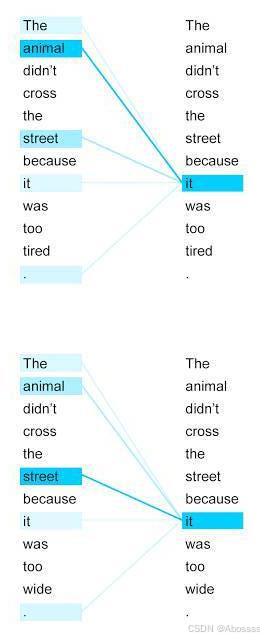
以句子 “我喜欢吃苹果” 为例,当模型处理 “苹果” 这个词时,多头自注意力机制的不同头可以分别关注到 “吃” 与 “苹果” 的语义关系(比如它们是动作与对象的关系),以及 “我” 与 “苹果” 在整个句子语境中的联系(表明 “我” 是 “吃苹果” 这个动作的执行者) 。通过这种方式,模型能够更全面、准确地理解句子中各个单词之间的关系 。
位置前馈神经网络是编码器的另一个重要组成部分,它对多头自注意力机制的输出进行进一步的非线性变换,以增强模型的表达能力 。这个网络由两个全连接层组成,中间使用 ReLU 激活函数 。虽然它的结构相对简单,但却能够为模型引入更多的非线性因素,从而更好地拟合复杂的函数关系 。在处理自然语言时,它可以对单词的向量表示进行进一步的特征提取和变换,使得模型能够更好地捕捉到语义信息 。例如,它可以对经过多头自注意力机制处理后的 “苹果” 的向量表示进行进一步加工,提取出更抽象的语义特征,如 “苹果” 作为一种水果的属性、在饮食文化中的意义等 。
为了提高训练的稳定性和效率,编码器的每个子层都采用了残差连接(Residual Connection)和层归一化(Layer Normalization)技术 。残差连接就像是一条信息高速公路,它将子层的输入直接与输出相加,使得信息能够更顺畅地在网络中传递,避免了梯度消失和梯度爆炸的问题 。层归一化则是对每个样本的特征进行归一化处理,使得网络在训练过程中更加稳定,加速收敛 。其计算公式为:
LN(x)=γx−μσ2+ϵ+β LN(x) = \gamma \frac{x - \mu}{\sqrt{\sigma^2 + \epsilon}} + \beta LN(x)=γσ2+ϵx−μ+β
其中,xxx是输入,μ\muμ和σ2\sigma^2σ2分别是输入的均值和方差,γ\gammaγ和β\betaβ是可学习的参数,ϵ\epsilonϵ是一个很小的常数,用于防止分母为零 。通过残差连接和层归一化,编码器能够更加高效地学习和训练,提升模型的性能 。
(二)解码器(Decoder)
解码器在 Transformer 模型中扮演着至关重要的角色,它就像是一位才华横溢的创作者,根据编码器提取的特征信息和已经生成的部分输出,逐步生成最终的目标序列 。在机器翻译任务中,解码器会根据编码器对源语言句子的编码结果,生成对应的目标语言句子 。例如,当源语言是英文 “Hello, how are you?”,解码器会生成中文译文 “你好,你怎么样?” 。
解码器同样由多个相同的层堆叠而成,每一层包含三个主要的子层:多头自注意力机制(Masked Multi-Head Self-Attention)、编码器 - 解码器注意力机制(Encoder-Decoder Attention)和位置前馈神经网络(Position-wise Feed-Forward Network) 。这些子层相互协作,共同完成从编码信息到目标序列的转换 。
与编码器类似,解码器的输入也需要经过输入嵌入和位置编码的预处理 。输入嵌入将目标序列的离散符号转换为连续的向量表示,位置编码则为这些向量添加位置信息,使模型能够感知到目标序列中元素的顺序 。
多头自注意力机制在解码器中起着关键作用,但与编码器中的多头自注意力机制有所不同 。在解码器中,为了防止模型在生成当前位置的输出时 “偷看” 到未来位置的信息,引入了掩蔽(Masking)操作 。掩蔽操作通过在计算注意力得分时,将未来位置的得分设置为负无穷(或一个非常小的值),使得模型在计算当前位置的注意力权重时,只能关注到当前位置及其之前的位置 。这样可以保证模型在生成序列时,是按照顺序依次生成的,符合人类语言生成的逻辑 。
以生成句子 “我喜欢吃苹果” 为例,当模型生成到 “吃” 这个词时,掩蔽多头自注意力机制会确保模型只能关注到已经生成的 “我喜欢” 这部分内容,而不会受到尚未生成的 “苹果” 的影响 。这样可以保证模型生成的句子在语法和语义上是合理的 。
编码器 - 解码器注意力机制是解码器的另一个核心组件,它使得解码器能够充分利用编码器提取的源序列信息 。在这个机制中,查询向量(Query)来自解码器的前一层输出,键向量(Key)和值向量(Value)则来自编码器的输出 。通过计算查询向量与键向量的注意力权重,解码器可以根据源序列中不同位置的信息,对当前要生成的位置进行加权求和,从而生成与源序列相关的目标序列 。
继续以上述机器翻译为例,当解码器生成中文译文中的某个词时,编码器 - 解码器注意力机制会让解码器关注到英文源句子中与之相关的单词,比如在生成 “你好” 时,会关注到英文句子中的 “Hello”,从而准确地生成对应的译文 。
位置前馈神经网络在解码器中的作用与在编码器中类似,它对经过多头自注意力机制和编码器 - 解码器注意力机制处理后的输出进行进一步的非线性变换,增强模型的表达能力 。通过两个全连接层和 ReLU 激活函数,对向量表示进行进一步的特征提取和变换,使得模型能够更好地生成符合语义和语法规则的目标序列 。
同样,为了保证训练的稳定性和效率,解码器的每个子层也采用了残差连接和层归一化技术 。残差连接将子层的输入与输出相加,避免梯度消失和梯度爆炸问题,层归一化对每个样本的特征进行归一化处理,加速模型的收敛 。通过这些技术的协同作用,解码器能够更加准确、高效地生成目标序列 。
(三)注意力机制详解
注意力机制是 Transformer 模型的核心,它赋予了模型强大的信息处理能力,使得模型能够在处理序列数据时,有针对性地关注到序列中的关键信息 。其核心思想源于人类在处理信息时的注意力分配方式 。当我们阅读一篇文章时,并不会平均地关注每一个单词,而是会根据上下文和语义重点,有选择地关注那些对理解文章关键的部分 。注意力机制就是模仿了这种人类的注意力模式,让模型能够自动学习到在处理每个位置时,应该关注输入序列中的哪些部分 。
在 Transformer 中,注意力机制的计算基于三个关键的向量:查询向量(Query, Q)、键向量(Key, K)和值向量(Value, V) 。这些向量都是通过对输入序列进行线性变换得到的 。具体计算过程如下:
首先,计算查询向量与键向量的点积,得到注意力得分(Attention Scores) 。这个点积操作可以衡量查询向量与每个键向量之间的相似度,得分越高,表示查询向量与对应的键向量越相似,也就意味着在处理当前位置时,应该更多地关注这个键向量所对应的位置 。计算公式为:
scores=QKT scores = QK^T scores=QKT
为了防止点积结果过大或过小,导致训练过程中的数值不稳定,通常会将注意力得分除以一个缩放因子,这个缩放因子一般是键向量维度的平方根 。这一步操作被称为缩放(Scaling),其目的是使注意力得分的方差保持在一个合适的范围内,从而提高模型的稳定性 。缩放后的注意力得分计算公式为:
scaled_scores=scoresdk scaled\_scores = \frac{scores}{\sqrt{d_k}} scaled_scores=dkscores
其中,dkd_kdk是键向量的维度 。
接下来,通过 softmax 函数对缩放后的注意力得分进行归一化处理,得到注意力权重(Attention Weights) 。softmax 函数会将注意力得分转换为概率分布,使得所有注意力权重之和为 1 。这些权重表示了在处理当前位置时,对输入序列中各个位置的关注程度 。注意力权重的计算公式为:
attention_weights=softmax(scaled_scores) attention\_weights = softmax(scaled\_scores) attention_weights=softmax(scaled_scores)
最后,将注意力权重与值向量相乘并求和,得到注意力机制的输出 。这个输出是对值向量的加权求和,其中权重就是前面计算得到的注意力权重 。通过这种方式,模型可以根据注意力权重,有针对性地从值向量中提取与当前位置相关的信息 。注意力机制的输出计算公式为:
output=attention_weightsV output = attention\_weightsV output=attention_weightsV
在实际应用中,为了进一步增强模型的表达能力,Transformer 采用了多头注意力机制(Multi-Head Attention) 。多头注意力机制通过多个并行的注意力头,同时从不同的子空间中对输入序列进行关注和特征提取 。每个注意力头都有自己独立的查询、键和值向量,它们通过不同的线性变换矩阵得到 。然后,将每个注意力头的输出拼接起来,再通过一个线性变换,得到多头注意力机制的最终输出 。
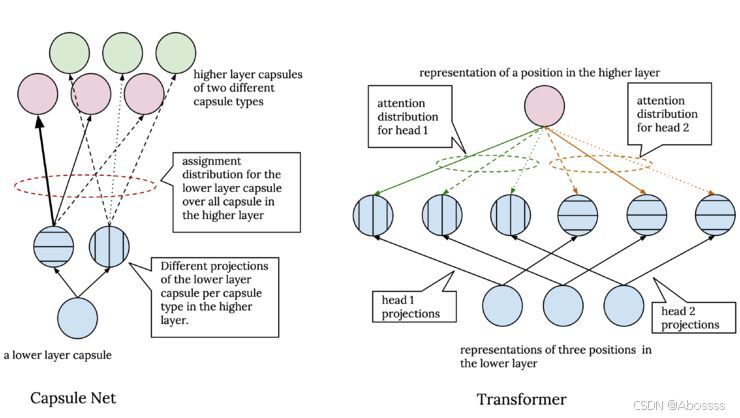
多头注意力机制可以让模型同时捕捉到输入序列中不同方面的信息,例如在自然语言处理中,不同的头可以分别关注到语法关系、语义关系、上下文信息等 。通过这种方式,模型能够更全面、深入地理解输入序列,从而提高模型的性能 。例如,在处理句子 “苹果从树上掉下来,牛顿发现了万有引力” 时,一个头可能关注到 “苹果” 与 “掉下来” 之间的动作关系,另一个头可能关注到 “牛顿” 与 “万有引力” 之间的因果关系,还有一个头可能关注到整个句子的上下文逻辑 。通过将这些不同头的信息整合起来,模型能够更准确地理解句子的含义 。
四、Transformer 优势大揭秘
(一)强大的并行计算能力
在计算效率的赛道上,Transformer 凭借其独特的自注意力机制,犹如一辆高速行驶的超级跑车,将传统模型远远甩在身后。与传统的循环神经网络(RNN)相比,RNN 在处理序列数据时,就像一位按部就班的工匠,必须按照时间顺序依次处理每个时间步的输入,信息的传递呈现出一种链式的依赖关系 。在处理一段长文本时,RNN 需要从文本的开头开始,逐个单词地进行处理,前一个时间步的计算结果必须等待完成后,才能作为下一个时间步的输入,这使得计算过程无法并行化,大大降低了计算效率 。
而 Transformer 则截然不同,它如同一位拥有超能力的魔法师,能够同时关注序列中的所有位置 。在自注意力层中,无论序列的长度是多少,它都可以一次性计算所有单词之间的注意力关系 。这就好比我们在阅读一篇文章时,Transformer 可以瞬间把握文章中每个单词之间的联系,而不需要逐字逐句地依次理解 。这种并行计算的特性,使得 Transformer 能够充分利用现代硬件的并行计算能力,如 GPU 的强大算力,大大缩短了训练和推理的时间 。在处理大规模的文本数据集时,Transformer 能够在短时间内完成训练,而 RNN 可能需要花费数倍甚至数十倍的时间 。
从计算资源的利用角度来看,Transformer 的并行计算能力也使得它在硬件资源的利用上更加高效 。由于可以同时处理多个位置的信息,Transformer 能够充分发挥硬件的并行处理能力,避免了资源的闲置和浪费 。而 RNN 由于其串行的计算方式,在处理长序列时,硬件资源往往无法得到充分利用,导致计算效率低下 。
(二)卓越的长序列处理能力
在处理长序列数据时,Transformer 展现出了卓越的能力,轻松克服了传统模型面临的梯度消失和梯度爆炸问题,成为了长序列处理领域的佼佼者 。以 RNN 为例,当处理长序列时,梯度在反向传播过程中会沿着时间步逐渐传递 。由于 RNN 的结构特点,梯度在传递过程中会不断地乘以权重矩阵,当权重矩阵的某些特征值大于 1 或小于 1 时,梯度就会随着时间步的增加而指数级地增长或衰减 。当梯度指数级衰减时,就会出现梯度消失问题,导致模型难以学习到长距离的依赖关系 。在分析一篇长文章时,文章开头的关键信息可能会因为梯度消失而无法对文章末尾的语义理解产生有效的影响 。当梯度指数级增长时,则会出现梯度爆炸问题,使得模型的训练变得不稳定,参数更新异常剧烈,无法收敛 。
Transformer 通过自注意力机制,巧妙地避开了这些问题 。自注意力机制允许模型在处理序列中的每个位置时,直接关注到序列中的其他任意位置,而不需要通过中间的时间步来传递信息 。这就像是在长距离的信息传递中建立了一条条高速公路,使得信息能够直接、快速地在不同位置之间传递 。在处理长文本时,Transformer 可以直接捕捉到文本开头和结尾的关键信息之间的联系,而不会受到梯度消失或梯度爆炸的影响 。例如,在分析一篇长篇小说时,Transformer 能够准确地理解小说开头埋下的伏笔与结尾的呼应关系,而不会因为文本长度的增加而丢失关键信息 。
为了更直观地说明 Transformer 在长序列处理上的优势,我们可以通过实验对比来观察 。在处理一篇长度为 1000 个单词的文本时,RNN 可能会因为梯度消失问题而无法准确捕捉到前 100 个单词与后 100 个单词之间的语义联系,导致对文本的整体理解出现偏差 。而 Transformer 则能够轻松地处理这种长序列,准确地把握文本中各个部分之间的关系,对文本的理解更加准确和全面 。
(三)灵活的可扩展性
Transformer 就像是一个拥有无限潜力的超级英雄,具有非常灵活的可扩展性,能够根据不同的任务需求和数据规模进行调整和优化,展现出强大的适应能力 。
在模型能力提升方面,Transformer 可以通过增加层数和注意力头数来显著提升其表达能力 。增加层数就像是为一座高楼不断地加盖楼层,每增加一层,模型就能够学习到更复杂、更抽象的特征表示 。随着层数的增加,Transformer 可以对输入序列进行更深入的分析和理解,捕捉到更细微的语义和语法关系 。增加注意力头数则像是为模型配备了多个不同视角的探测器,每个头都可以从不同的角度关注输入序列,捕捉到不同类型的信息 。有的头可以关注到词汇之间的语义相似性,有的头可以关注到句子的语法结构,还有的头可以关注到文本的上下文逻辑关系 。通过将这些不同头捕捉到的信息整合起来,模型的表达能力得到了极大的增强 。
这种可扩展性使得 Transformer 能够适应各种不同规模和难度的任务 。在面对简单的任务时,如短文本分类,我们可以使用相对较小规模的 Transformer 模型,减少计算资源的消耗,同时保证模型的准确性 。而在处理复杂的任务,如大规模的语言生成任务时,我们可以通过增加层数和注意力头数,构建更大规模的 Transformer 模型,以满足任务对模型能力的要求 。GPT-3 拥有高达 1750 亿个参数,通过大规模的训练和强大的模型能力,在自然语言生成领域展现出了惊人的表现 。
在实际应用中,Transformer 的可扩展性也得到了充分的验证 。在机器翻译领域,随着数据规模的不断增大和翻译任务的复杂性不断提高,研究人员通过增加 Transformer 模型的层数和注意力头数,不断提升模型的翻译质量和效率 。在图像识别领域,Vision Transformer(ViT)通过对 Transformer 结构的调整和扩展,成功地将 Transformer 应用于图像数据的处理,在图像分类、目标检测等任务中取得了与传统卷积神经网络相媲美的性能 。
五、Transformer 的广泛应用
(一)自然语言处理(NLP)领域
在自然语言处理这个充满挑战与机遇的领域中,Transformer 凭借其强大的能力,成为了众多任务的核心驱动力,展现出了卓越的应用效果和无可比拟的优势 。
在机器翻译任务中,Transformer 堪称一把精准而高效的语言转换利器。传统的机器翻译模型,如基于循环神经网络(RNN)的模型,在处理长句子时,由于其顺序性的处理方式和难以捕捉长距离依赖关系的缺陷,常常会出现翻译不准确、语义不连贯的问题 。而 Transformer 的出现,彻底改变了这一局面 。它通过自注意力机制,能够同时关注源语言句子中的各个单词,准确地捕捉到单词之间的语义和语法关系,从而实现更加流畅、准确的翻译 。谷歌的神经机器翻译系统(GNMT)采用 Transformer 架构后,在多种语言对的翻译任务中,翻译质量得到了显著提升,翻译结果更加自然、通顺,极大地促进了跨语言交流 。
文本分类是自然语言处理中的一项基础而重要的任务,Transformer 在这个领域也表现出色 。以情感分析为例,它可以快速准确地判断一段文本所表达的情感倾向是积极、消极还是中性 。Transformer 通过对文本中的词汇、语法和语义信息进行深度挖掘和分析,能够准确地捕捉到文本中的情感线索 。在对电影评论进行情感分析时,Transformer 可以理解评论中的词汇选择、句子结构以及上下文关系,从而准确判断出评论者对电影的喜爱或厌恶之情 。与传统的文本分类方法相比,Transformer 能够更好地处理长文本,并且在面对复杂的语义和语境时,依然能够保持较高的分类准确率 。
问答系统是自然语言处理领域的一个热门研究方向,Transformer 为其发展注入了强大的动力 。Transformer 可以理解用户的问题,并从大量的文本数据中准确地提取出相关的答案 。在智能客服系统中,当用户提出问题时,基于 Transformer 的问答系统能够快速理解问题的含义,然后在知识库中进行搜索和匹配,给出准确、详细的回答 。它不仅能够回答简单的事实性问题,还能够处理一些复杂的推理和理解问题,大大提高了问答系统的智能化水平和用户体验 。
(二)计算机视觉(CV)领域
Transformer 在计算机视觉领域的应用,为这个领域带来了全新的发展机遇和突破,展现出了独特的优势和巨大的潜力 。
在图像分类任务中,传统的卷积神经网络(CNN)一直占据着主导地位 。然而,Vision Transformer(ViT)的出现,打破了这种传统格局 。ViT 将 Transformer 架构应用于图像分类,它将图像划分为多个小块(patch),并将这些小块视为序列中的元素,然后利用 Transformer 的自注意力机制对这些元素进行处理 。这种方法使得模型能够更好地捕捉图像中的全局信息,而不仅仅局限于局部特征 。在大规模图像分类数据集上的实验表明,ViT 在处理高分辨率图像时,能够取得与传统 CNN 相媲美的性能,甚至在某些情况下表现更优 。对于一张包含多种物体的复杂图像,ViT 可以通过自注意力机制,同时关注到图像中不同物体的特征和它们之间的关系,从而更准确地判断图像的类别 。
目标检测是计算机视觉中的另一个重要任务,Transformer 也在这个领域取得了显著的成果 。DETR(Detection Transformer)是首个将 Transformer 应用于目标检测的模型,它摒弃了传统目标检测算法中复杂的锚框(anchor)机制,而是直接使用 Transformer 对图像进行编码,并通过端到端的方式预测目标的类别和位置 。DETR 的这种创新设计,使得模型的结构更加简洁,同时也提高了检测的准确性和效率 。在处理复杂场景下的目标检测任务时,DETR 可以通过自注意力机制,更好地理解图像中目标物体与周围环境的关系,从而更准确地检测出目标物体的位置和类别 。
图像生成是计算机视觉领域中一个充满创意和挑战的方向,Transformer 也为其带来了新的思路和方法 。基于 Transformer 的图像生成模型可以根据给定的文本描述或图像特征,生成逼真的图像 。这些模型通过学习大量的图像和文本数据,能够理解图像和文本之间的语义关联,从而实现从文本到图像的转换 。当给定 “一只在草原上奔跑的骏马” 这样的文本描述时,基于 Transformer 的图像生成模型可以生成一幅栩栩如生的骏马在草原上奔跑的图像,图像中的骏马形态逼真,草原的背景也十分生动 。
(三)其他领域应用
Transformer 的强大能力使其在多个领域都得到了广泛的应用,为这些领域的发展带来了新的机遇和突破 。
在语音识别领域,Transformer 为语音信号的处理和理解提供了新的解决方案 。传统的语音识别模型通常基于隐马尔可夫模型(HMM)或循环神经网络(RNN),这些模型在处理长语音序列时存在一定的局限性 。而 Transformer 通过自注意力机制,能够有效地捕捉语音信号中的长距离依赖关系,从而提高语音识别的准确率 。在实时语音转文字的应用中,Transformer 可以快速准确地将语音信号转换为文本,即使在嘈杂的环境中,也能保持较高的识别准确率 。
推荐系统是现代互联网应用中不可或缺的一部分,Transformer 的应用使得推荐系统的性能得到了显著提升 。Transformer 可以通过分析用户的历史行为数据,如浏览记录、购买记录等,挖掘用户的兴趣偏好和行为模式,从而为用户提供更加个性化的推荐 。在电商平台中,基于 Transformer 的推荐系统可以根据用户的历史购买记录,准确地推荐用户可能感兴趣的商品,提高用户的购买转化率 。在视频平台中,Transformer 可以根据用户的观看历史和偏好,推荐符合用户口味的视频内容,提升用户的观看体验 。
在音频处理领域,Transformer 也展现出了强大的能力 。它可以用于音频分类、音频生成等任务 。在音频分类中,Transformer 可以对音频信号进行分析和特征提取,判断音频的类别,如音乐、语音、环境声音等 。在音频生成中,Transformer 可以根据给定的文本描述或音频特征,生成相应的音频内容 。通过输入一段描述音乐风格和情感的文本,基于 Transformer 的音频生成模型可以生成一段符合描述的音乐片段 。
六、Transformer 发展面临的挑战与未来展望
(一)现存挑战
尽管 Transformer 在 AI 领域取得了辉煌成就,但它并非完美无缺,在发展过程中仍面临着诸多严峻的挑战。
首先,Transformer 模型的参数效率相对较低。自注意力机制在计算过程中需要计算输入序列中每个位置与其他位置之间的相关性,这导致参数数量随输入序列长度的增加而急剧增加 。在处理大规模数据集时,庞大的参数数量使得 Transformer 模型需要消耗大量的计算资源和存储空间,大大增加了训练时间和成本 。GPT-3 拥有高达 1750 亿个参数,训练这样一个模型需要使用大量的 GPU 资源,并且训练时间长达数月之久 。这不仅限制了 Transformer 模型在资源受限环境中的应用,也使得模型的部署和维护变得更加困难 。
其次,Transformer 模型对输入数据的敏感性较高。在处理复杂任务时,如机器翻译、语音识别等,输入数据的细微变化都可能对模型的输出结果产生较大影响 。这是因为 Transformer 模型依赖于输入数据的全局信息进行建模,输入数据中的任何噪声、错误或偏差都可能被模型捕捉并放大,从而影响模型的判断和决策 。在机器翻译中,如果输入的源语言句子存在语法错误或拼写错误,Transformer 模型可能会生成不准确的翻译结果 。
再者,Transformer 模型难以处理时空动态变化的信息。Transformer 本质上是基于自注意力机制的静态模型,它在处理序列数据时,假设输入序列中的元素是固定不变的,无法有效地捕捉到时空动态变化的信息 。在处理视频数据时,视频中的物体位置、动作和场景都是随时间变化的,Transformer 模型很难直接处理这种动态变化的信息 。在处理实时金融数据时,市场行情的波动是实时变化的,Transformer 模型在捕捉这些动态变化的规律方面存在一定的局限性 。
(二)未来发展方向
面对这些挑战,研究人员正积极探索 Transformer 的未来发展方向,致力于提升其性能和应用范围。
模型压缩与优化是当前的研究热点之一。通过采用模型压缩技术,如权重剪枝、量化和知识蒸馏等,可以有效地减少 Transformer 模型的参数数量和计算复杂度,提高模型的运行效率 。权重剪枝可以删除模型中不重要的连接和参数,从而减少模型的大小和计算量;量化技术则可以将模型的参数从高精度的浮点数转换为低精度的整数,以降低存储需求和计算成本;知识蒸馏是将大模型的知识转移到小模型中,使得小模型能够在保持较高性能的同时,减少计算资源的消耗 。这些技术的应用可以使 Transformer 模型在资源受限的设备上,如移动设备和嵌入式系统中,也能够高效运行 。
跨模态学习是 Transformer 未来发展的另一个重要方向。随着数据类型的日益丰富,如何有效地融合和处理多种模态的数据,如图像、文本、音频等,成为了研究的重点 。Transformer 在处理多模态数据方面具有一定的优势,通过设计合适的架构和算法,可以实现不同模态数据之间的信息交互和融合 。多模态 Transformer 可以同时处理图像和文本数据,实现图像描述生成、视觉问答等任务 。在图像描述生成中,模型可以根据图像的内容生成相应的文本描述,将图像信息和文本信息有机地结合起来 。
预训练模型的持续发展也是 Transformer 未来的重要趋势。随着算力的不断提升和数据量的持续增长,预训练模型将不断进化,学习到更丰富、更深入的知识 。未来的预训练模型可能会在更多的领域和任务中发挥重要作用,并且能够更好地适应复杂多变的实际应用场景 。通过在大规模的多领域数据上进行预训练,模型可以学习到通用的知识和能力,然后在不同的任务中进行微调,实现快速适应和高效执行 。同时,预训练模型的可解释性和安全性也将成为研究的重点,以确保模型的决策和行为是可理解和可靠的 。
可以预见,在未来,Transformer 将继续在 AI 领域发挥重要作用,为解决各种复杂问题提供强大的技术支持 。随着研究的不断深入和技术的持续创新,Transformer 有望克服当前面临的挑战,实现更加广泛和深入的应用,为推动人工智能技术的发展和社会的进步做出更大的贡献 。
七、总结
Transformer 作为人工智能领域的重要基石,凭借其独特的自注意力机制和精妙的架构设计,成功打破了传统模型在处理序列数据时的诸多束缚 。它在自然语言处理、计算机视觉等多个领域的广泛应用和卓越表现,不仅推动了学术研究的深入发展,也为众多实际应用场景带来了创新性的解决方案 。
Transformer 在并行计算、长序列处理和可扩展性等方面展现出的显著优势,使其成为解决复杂问题的有力工具 。它能够高效地处理大规模数据,捕捉到数据中隐藏的复杂模式和关系,为模型的训练和推理提供了强大的支持 。然而,我们也必须清醒地认识到,Transformer 在发展过程中仍然面临着一些挑战,如参数效率较低、对输入数据敏感以及难以处理时空动态变化等问题 。这些挑战不仅限制了 Transformer 在某些场景下的应用,也为研究人员提出了新的课题 。
展望未来,随着技术的不断进步和研究的持续深入,我们有理由相信 Transformer 将在解决现有问题的基础上,实现更加卓越的性能和更广泛的应用 。模型压缩与优化技术将使 Transformer 在资源受限的环境中也能高效运行;跨模态学习将拓展 Transformer 的应用边界,使其能够处理更加复杂多样的数据;预训练模型的持续发展将为 Transformer 注入更强大的知识和能力,使其在各种任务中表现得更加出色 。
Transformer 的出现和发展,是人工智能领域的一次重大突破,它为我们打开了一扇通往更智能未来的大门 。在未来的研究和应用中,我们需要充分发挥 Transformer 的优势,不断探索创新,克服其面临的挑战,让这一强大的模型在人工智能的舞台上绽放出更加耀眼的光芒 。
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 15
 0
- 0


 已为社区贡献4条内容

所有评论(0)