这对CP太猛了!Mamba+Transformer狂刷顶会,引领AI新浪潮!
人工智能领域正迎来一场革命性的变革,Mamba与Transformer的强强联合成为学界新宠。
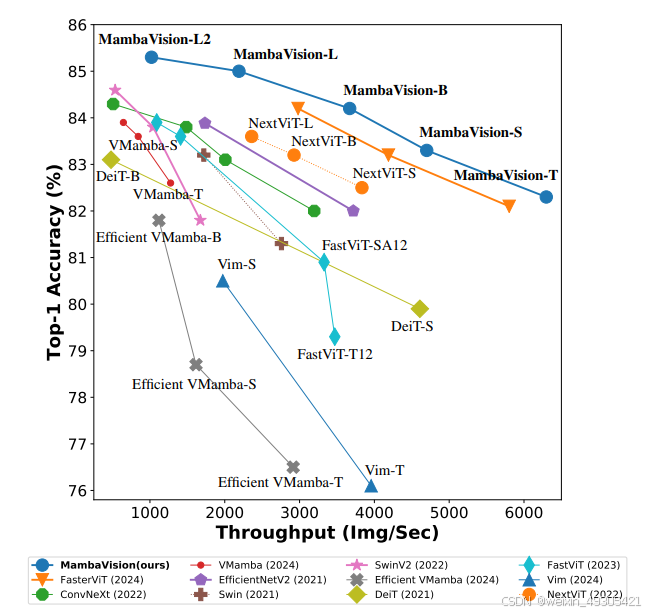
在计算机视觉前沿,英伟达团队打造的MambaVision惊艳亮相CVPR 2025。该模型采用创新的四阶段分层架构:前两阶段依托CNN层实现高分辨率特征快速提取,后两阶段巧妙融合Mamba与Transformer模块。研究团队对Mamba模块进行深度改造,用常规卷积替代因果卷积,并创新性地引入对称分支结构。这一突破性设计使MambaVision在Top-1精度和图像吞吐量上双双刷新纪录,树立了新的性能标杆。
自然语言处理领域。腾讯推出的Hunyuan-TurboS作为全球首款超大规模混合Transformer-Mamba MoE模型,开创性地解决了传统Transformer在长文本处理中的效率瓶颈。该模型充分发挥Mamba的长序列处理优势和Transformer的上下文理解能力,在训练优化和奖励机制方面均有重大创新。
这两项突破性研究开创了Mamba与Transformer融合的新范式,在各自领域树立了新的里程碑。
当前该领域研究热度持续升温,成果频出。我精选12篇前沿论文,为研究者深入理解这一技术趋势提供有力参考。
【论文精读】MambaVision:混合视觉骨干网络新标杆
1. 创新架构解析
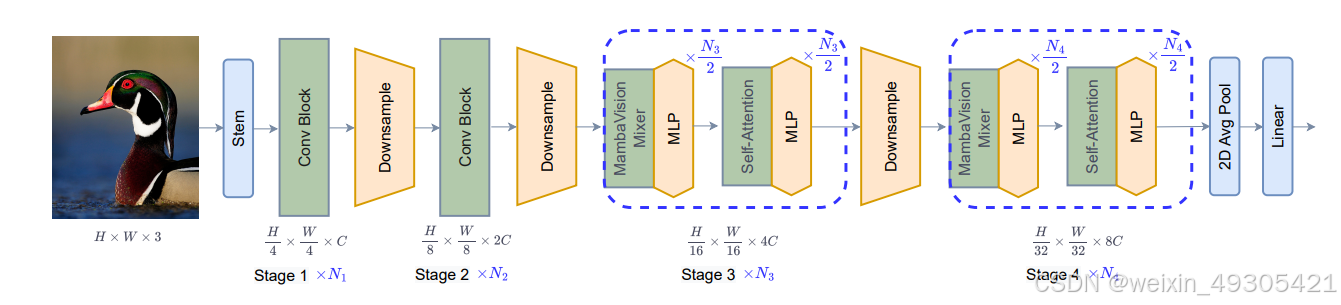
MambaVision采用独特的四阶段分层架构:
- 前两阶段:基于CNN层实现高分辨率特征快速提取,采用特定残差块公式
- 后两阶段:创新融合MambaVision与Transformer模块
- 特征处理:图像输入转换为重叠补丁并投影至嵌入空间
- 分辨率优化:通过批归一化的3×3 CNN层实现阶段间下采样
关键技术突破:
- Mamba模块重构:用常规卷积替代因果卷积,新增无SSM对称分支
- 特征融合:采用通用多头自注意力机制,显著提升视觉任务性能
2. 核心创新亮点
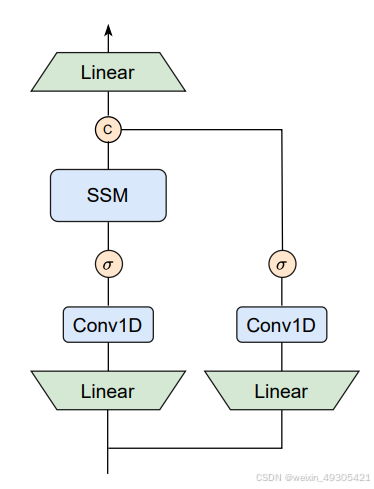
- Mamba模块重构:优化原始架构,专为视觉任务定制,实现精度与吞吐量双提升
- 混合架构探索:系统研究Mamba与Transformer集成模式,发现后期融入自注意力模块可显著增强全局上下文捕捉能力
- 性能突破:在ImageNet-1K数据集上实现Top-1准确率和图像吞吐量双SOTA,全面超越Mamba、CNN和ViT模型
论文链接:https://arxiv.org/pdf/2407.08083
【腾讯重磅发布】Hunyuan-TurboS:超大规模混合Transformer-Mamba MoE模型
1. 技术架构解析
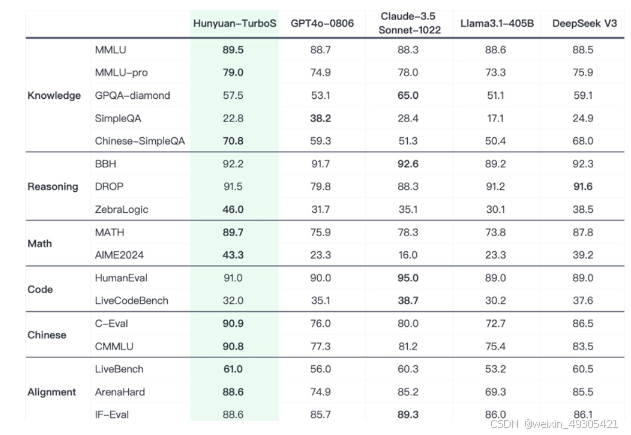
Hunyuan-TurboS开创多项原创性技术:
- 架构创新:融合Mamba与Transformer优势,Mamba将长文本处理复杂度降至O(n),显著降低缓存占用,Transformer确保上下文深度理解
- 训练优化:引入慢思考机制提升数理推理能力,通过精细化指令调优增强人机交互体验
- 奖励机制:创新性整合规则评分、代码沙箱反馈和生成式奖励,确保输出质量
2. 创新亮点
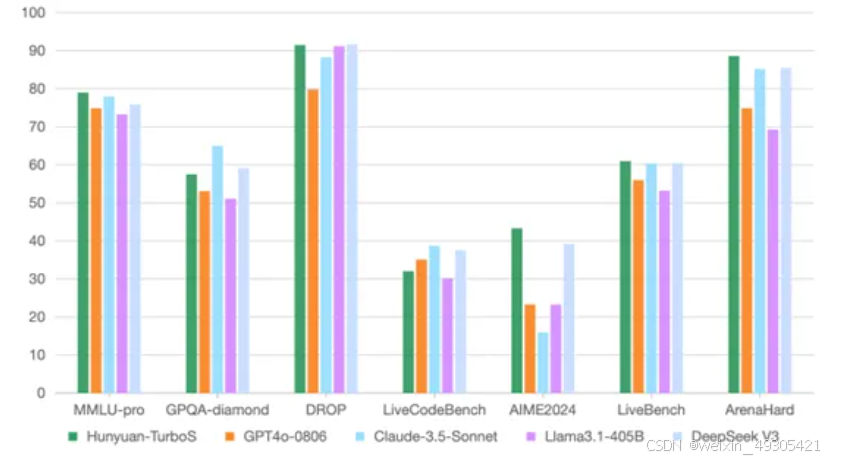
架构创新
- 混合架构:开创性融合Mamba与Transformer,实现显存与计算效率双优化
- MoE机制:采用动态专家混合机制,长文处理成本降低超60%
训练优化
- 慢思考集成:整合混元T1慢思考模型数据,显著提升数学、编程和推理任务表现
- 指令调优:精细化指令调优增强模型对齐性,优化Agent执行能力
- 英语优化:针对性英语训练优化,提升全球场景适用性
奖励系统
- 规则评分:基于规则的评分验证机制确保输出可靠性
- 代码沙箱:引入代码沙箱反馈,显著提升STEM领域准确性
- 生成式奖励:创新性采用生成式奖励优化问答与创意任务
项目链接:https://x.com/TXhunyuan/status/1899105803073958010
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 23
 0
- 0


 已为社区贡献4条内容

所有评论(0)