YOLO目标检测
一、YOLO介绍
YOLO(You Only Look Once)是一种基于深度学习的目标检测算法,由Joseph Redmon等人于2016年提出。它的核心思想是将目标检测问题转化为一个回归问题,通过一个神经网络直接预测目标的类别和位置。YOLO算法将输入图像分成SxS个网格,每个网格负责预测该网格内是否存在目标以及目标的类别和位置信息。此外,YOLO算法还采用了多尺度特征融合的技术,使得算法能够在不同尺度下对目标进行检测。
相比于传统的目标检测算法,如R-CNN、Fast R-CNN和Faster R-CNN等,YOLO算法具有更快的检测速度和更高的准确率。这得益于其端到端训练方式和单阶段检测的特性,使其可以同时处理分类和定位任务,避免了传统方法中的多阶段处理过程。因此,YOLO算法广泛应用于实时目标检测和自动驾驶等领域。
二、两种检测方法
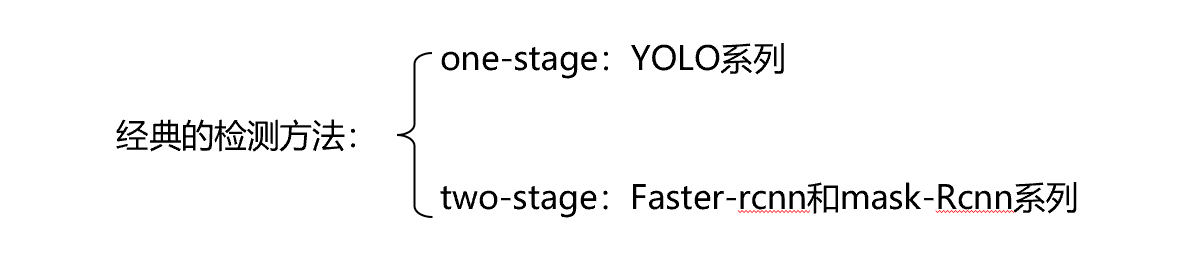
2.1 one-stage
工作原理
特征提取:使用卷积神经网络(CNN)对输入图像进行特征提取,得到不同层次的特征图。这些特征图包含了图像的不同语义信息和空间信息。
目标预测:在特征图上,通过一系列的卷积层和全连接层,直接预测目标的类别概率和边界框坐标。对于每个位置,都会预测多个不同大小和 aspect ratio 的边界框,以及这些边界框属于不同类别的概率。
后处理:对预测得到的边界框和类别概率进行后处理,通常包括非极大值抑制(NMS)等操作,以去除重复的检测结果,得到最终的检测结果。
优点:识别速度非常快,适合做实时检测任务
缺点:正确率相比较低
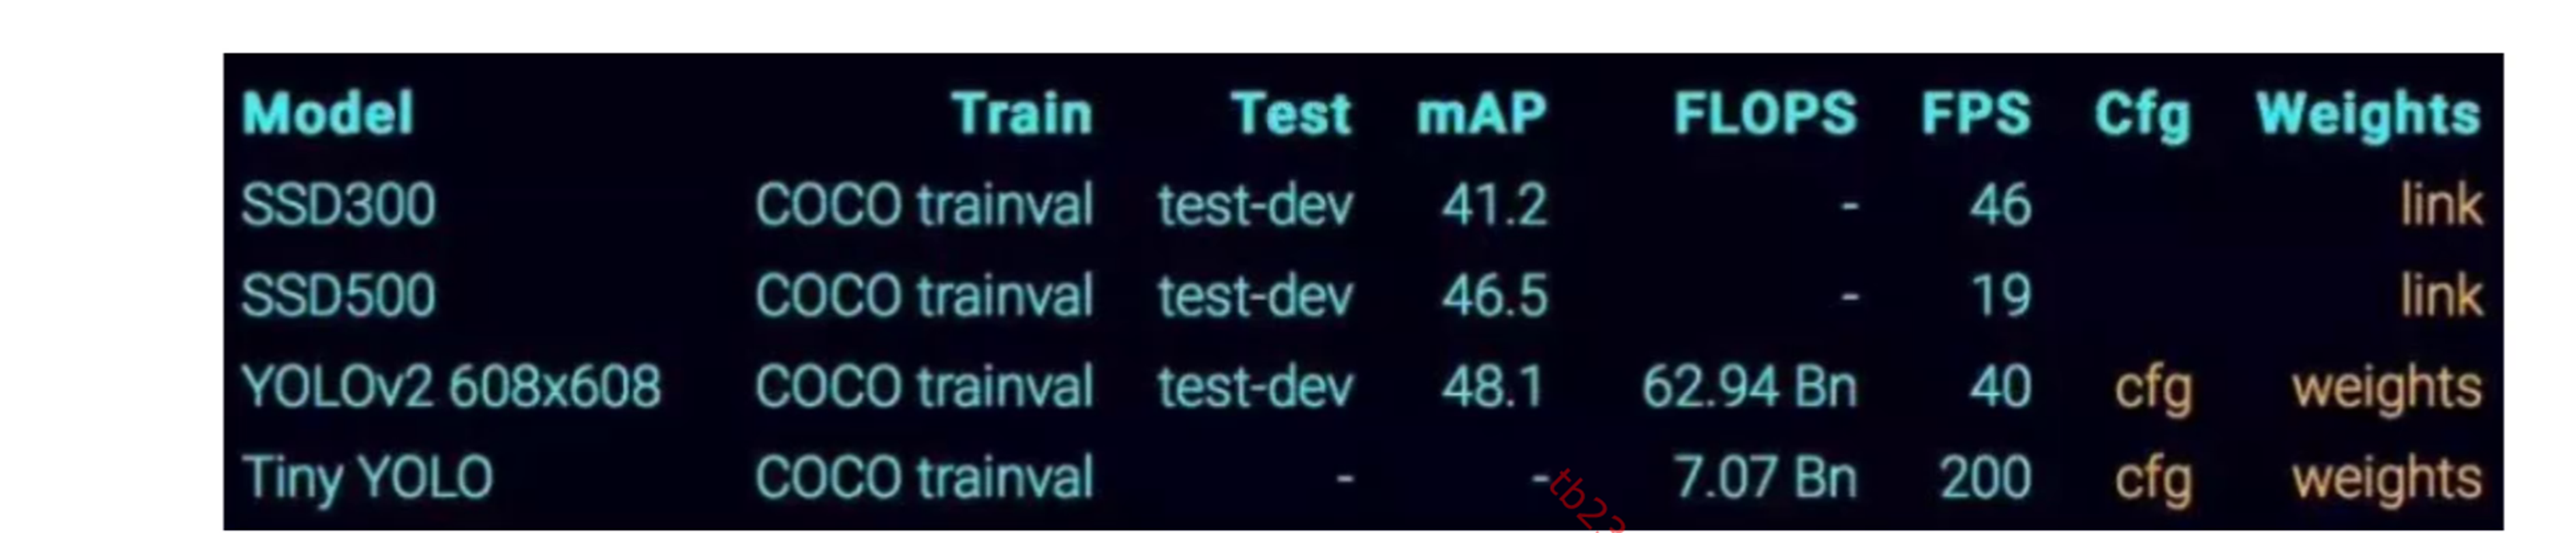
FLOPs表示模型进行一次前向传播(即处理一张图像)所需要的浮点运算次数。它是一个衡量算法效率的关键指标,与模型的计算量和推断速度密切相关。
FPS:每秒可以处理的图像数量
2.2 two-stage
工作原理
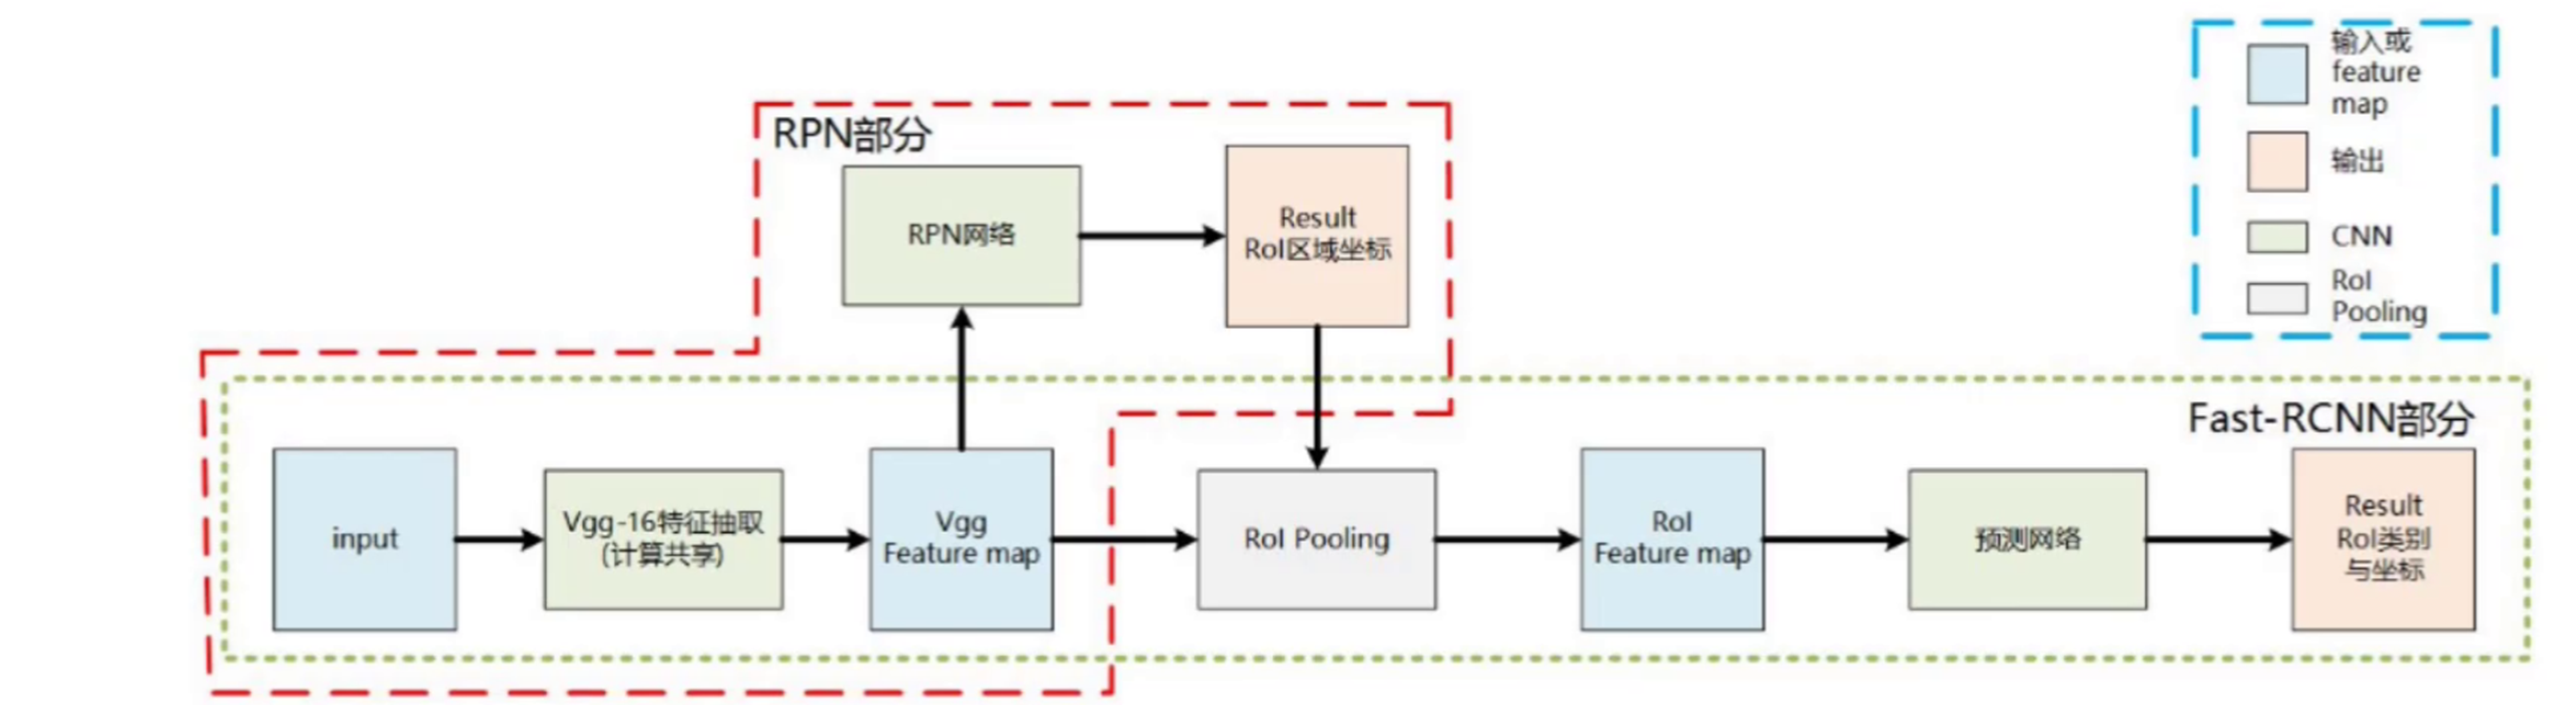
两阶段目标检测器是一种先生成候选框,然后对候选框进行分类和回归的检测方法。这种方法主要包括两个阶段:
代表性的两阶段目标检测器包括R-CNN系列,以及其改进版本Fast R-CNN、Faster R-CNN和Mask R-CNN等。
two-stage的优缺点:
优点:正确率比较高,识别效果理想
缺点:识别速度比较慢,通常达到5FPS
三、Map指标
在目标检测任务中,mAP(mean Average Precision)是一个常用的评估指标,用于衡量模型的检测性能。以下是关于 mAP 指标的详细介绍:
基本概念
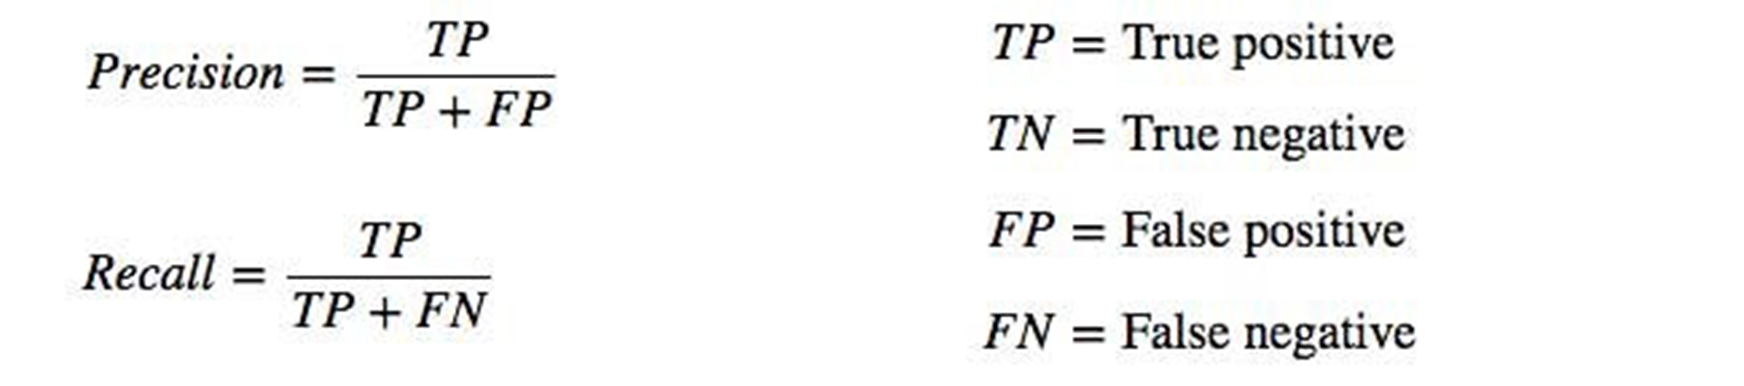
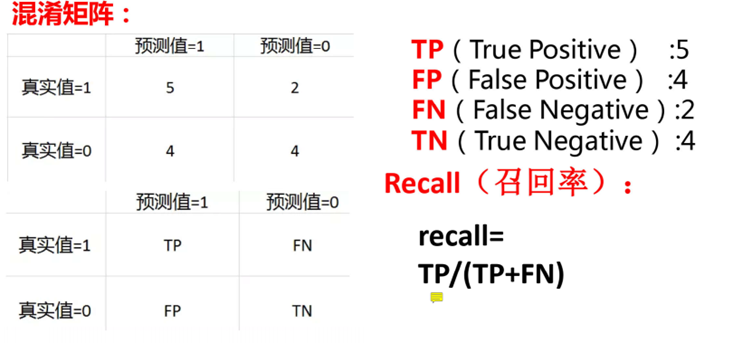
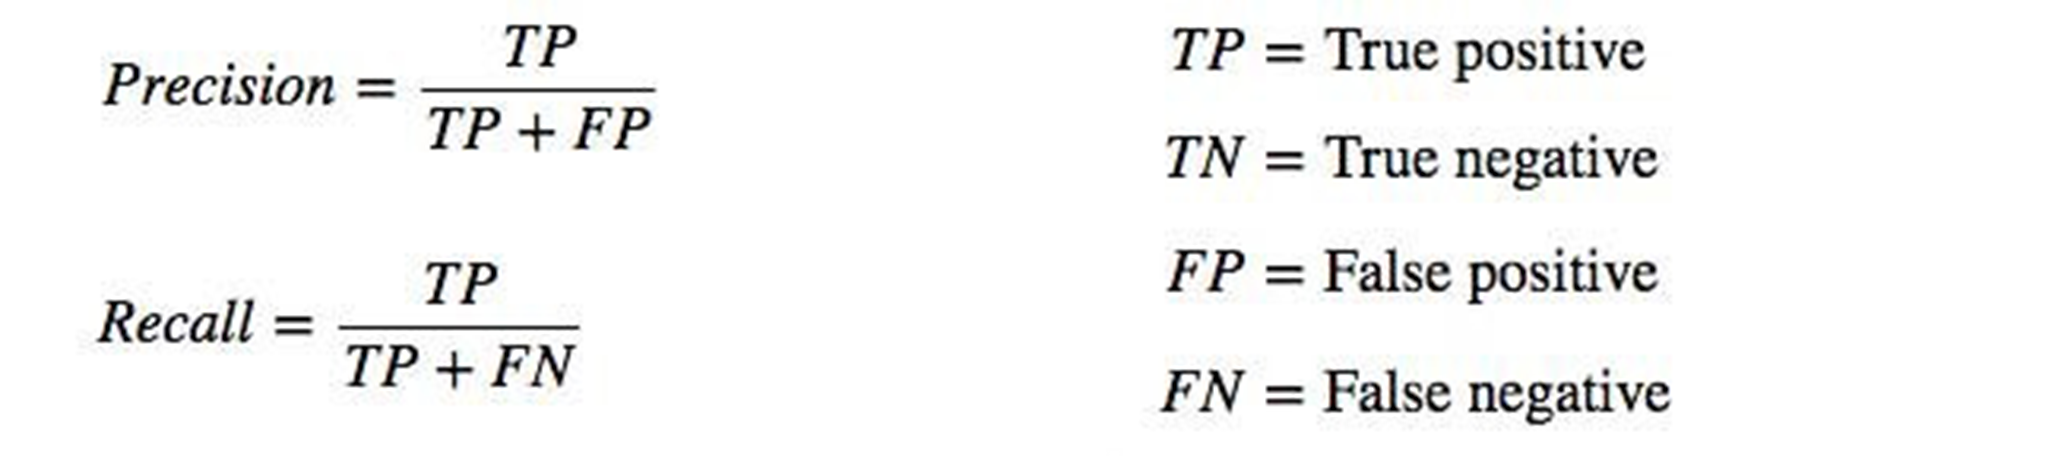
AP(Average Precision):平均精度,是针对单个类别而言的。它表示在不同召回率水平下,精度的平均值。精度(Precision)是指预测为正例的样本中,真正例的比例;召回率(Recall)是指真实正例中,被预测为正例的比例。计算 AP 时,通常会在召回率从 0 到 1 的范围内,选取若干个召回率阈值,计算对应的精度,然后求平均。
mAP:是对所有类别 AP 的平均值,用于综合评估模型在多个类别上的检测性能。mAP 的值越高,说明模型的检测效果越好。
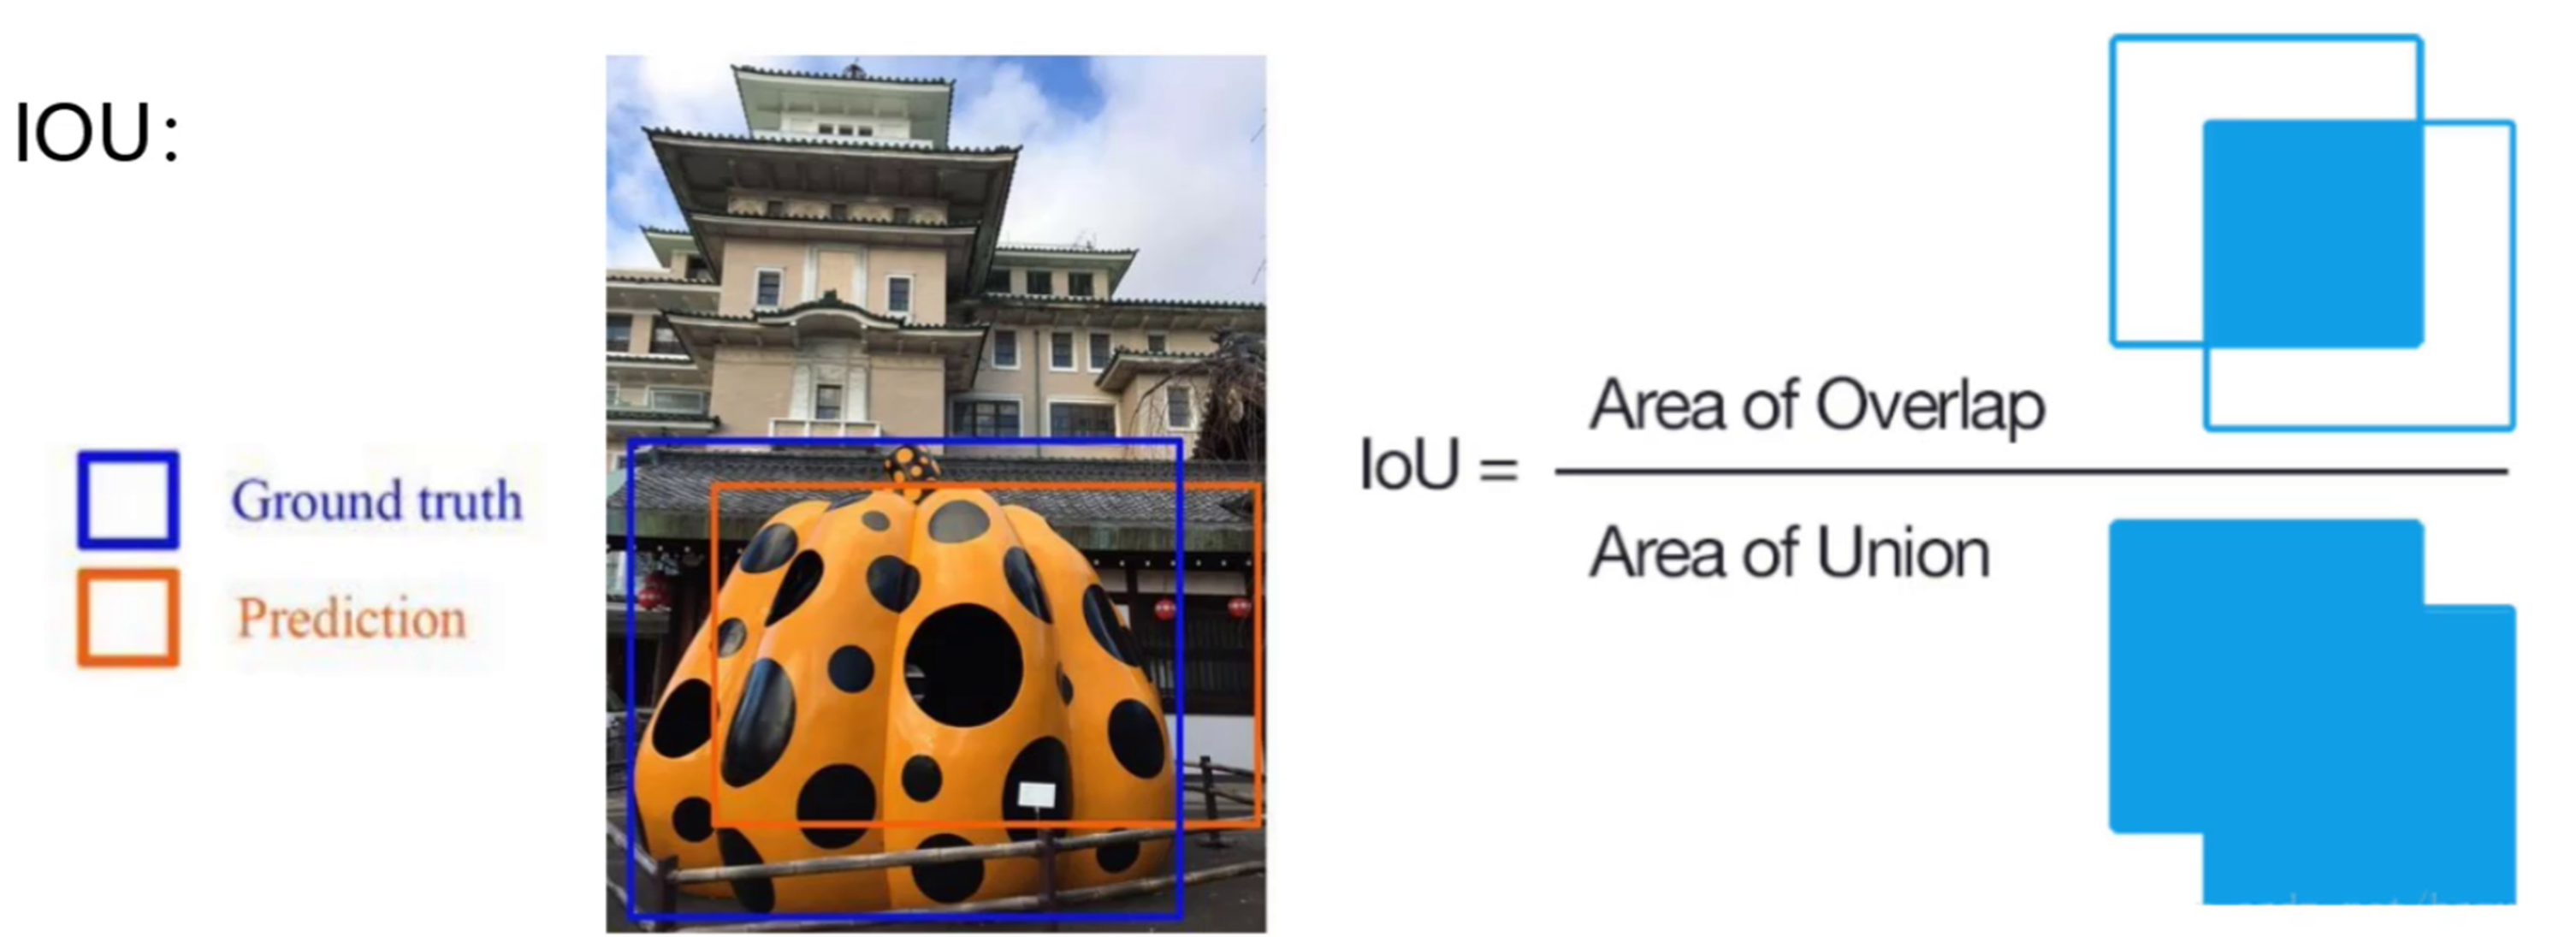
IOU:实际上就是预测框和真实框面积的交集与并集的比值(两边界框相交部分面积与相并部分面积之比)。我们认为只有loU>0.5的priorbox才是有价值的。
四、置信度
表示某个预测框中存在目标的可能性大小,是一个介于 0 到 1 之间的数值。例如,一个预测框的目标存在置信度为 0.8,意味着模型有 80% 的把握认为该预测框中包含一个目标。
精确率:预测的结果中有多少是正确的
召回率:真实的结果中有多少是预测正确的
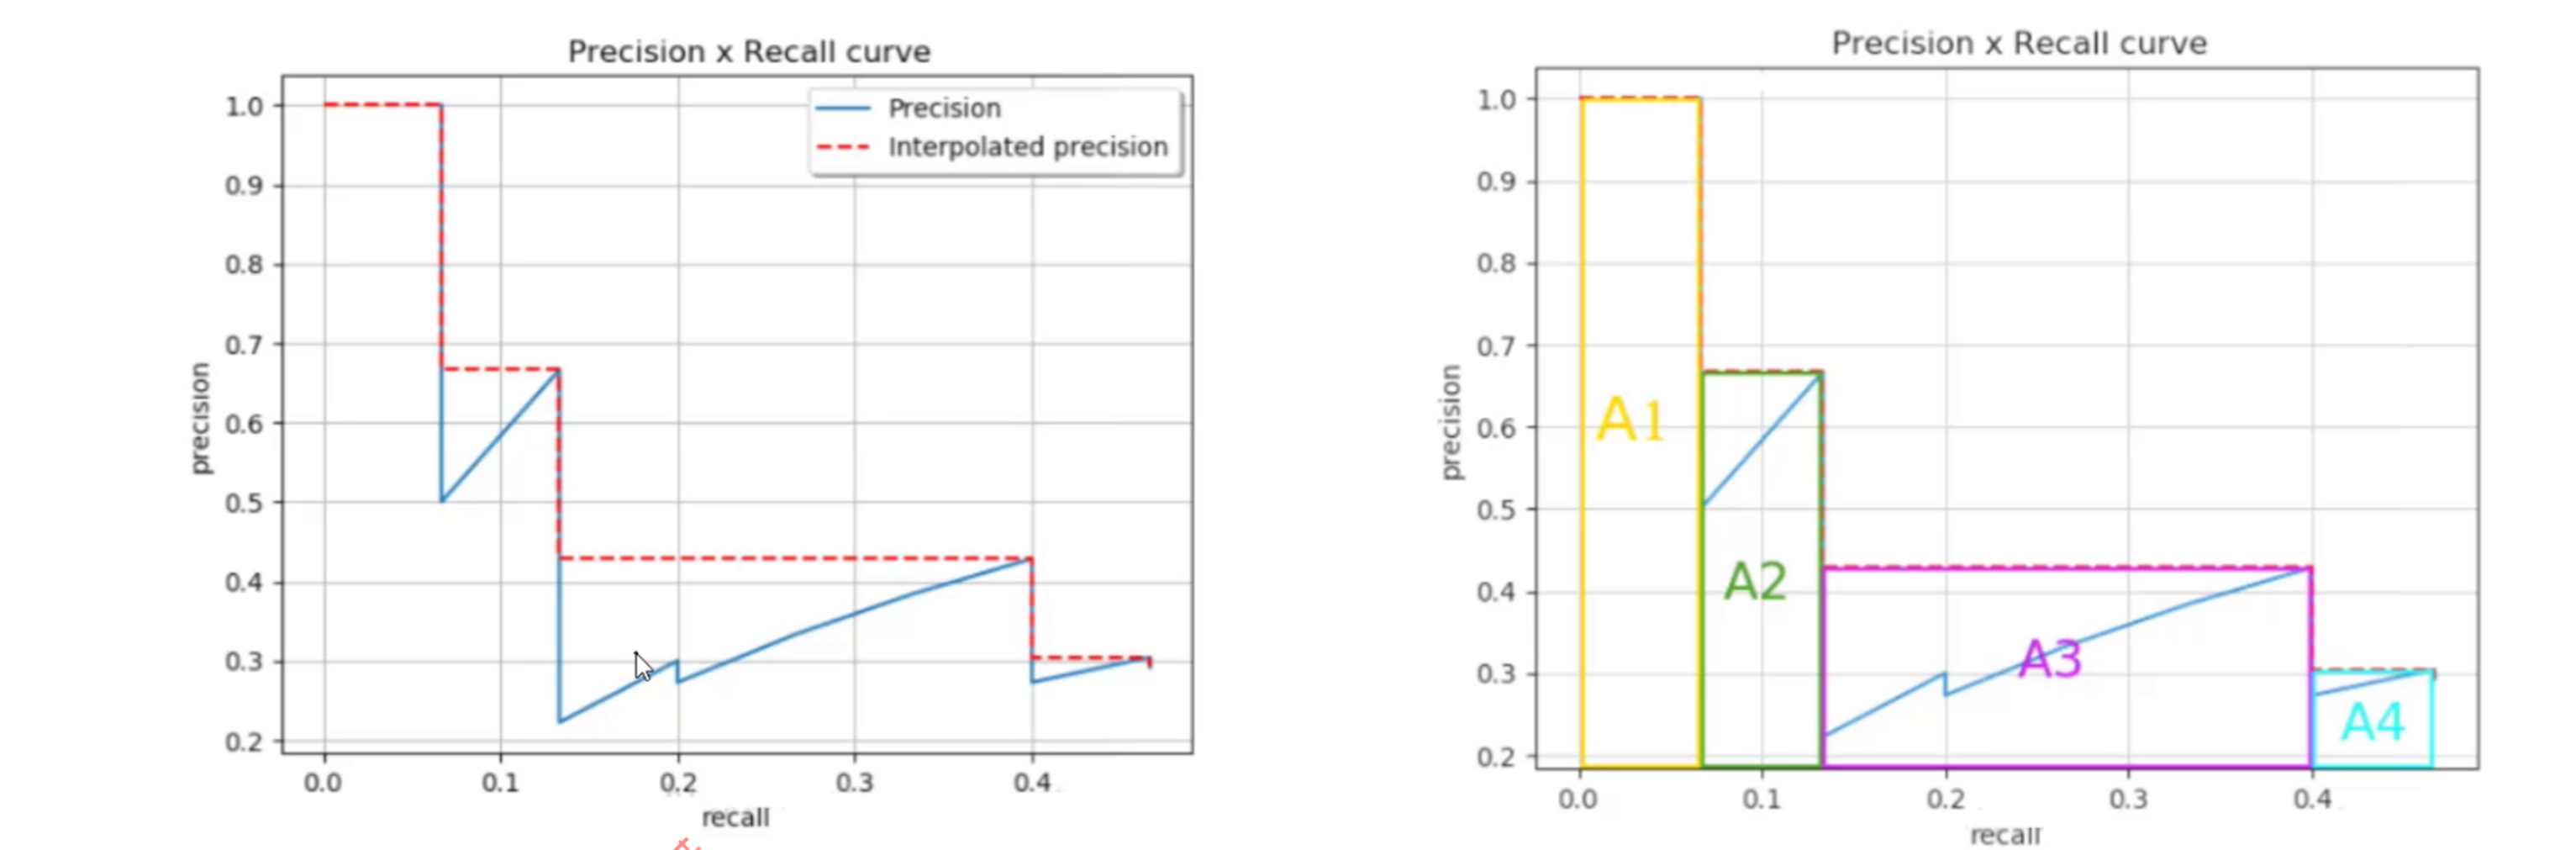
根据不同的阈值,绘制出召回率和精确率的曲线,将曲线以下的面积作为MAP值。当MAP值越大,则表示指标越好 。
mAP50:表示当 IoU 阈值为 0.5 时模型的平均精度。即只考虑预测框与真实框的重叠部分达到 50% 及以上的情况,计算所有类别的 AP(Average Precision)的平均值,AP 衡量的是随着不同置信度阈值的召回率变化,精度是如何变化的。mAP50 是一个固定的评估标准,仅关注 IoU 为 0.5 这一特定阈值下的模型性能。
mAP50 - 95:衡量的是模型在 IoU 阈值从 0.5 到 0.95 范围内的平均精度。计算的是所有类别的 AP 的平均值,其中 AP 是在 IoU 阈值从 0.5 到 0.95 的每个 0.05 步长上计算的。mAP50 - 95 考虑了更广泛的 IoU 范围,能够评估模型在不同重叠程度下的性能,提供了更全面的模型性能评估,是一个更严格的评估指标,其值通常比 mAP50 要低。
经典的one-stage方法
YOLO(You Only Look Once)算法是一种目标检测算法,把检测问题转换为回归问题,输出x,y,w,h。一个cnn就可以解决可以对视频进行实时检测,应用领域非常广

核心思想:将一幅图像分成SxS个网格(grid cell),如果某个object的中心 落在这个网格中,则这个网格就负责预测这个object。
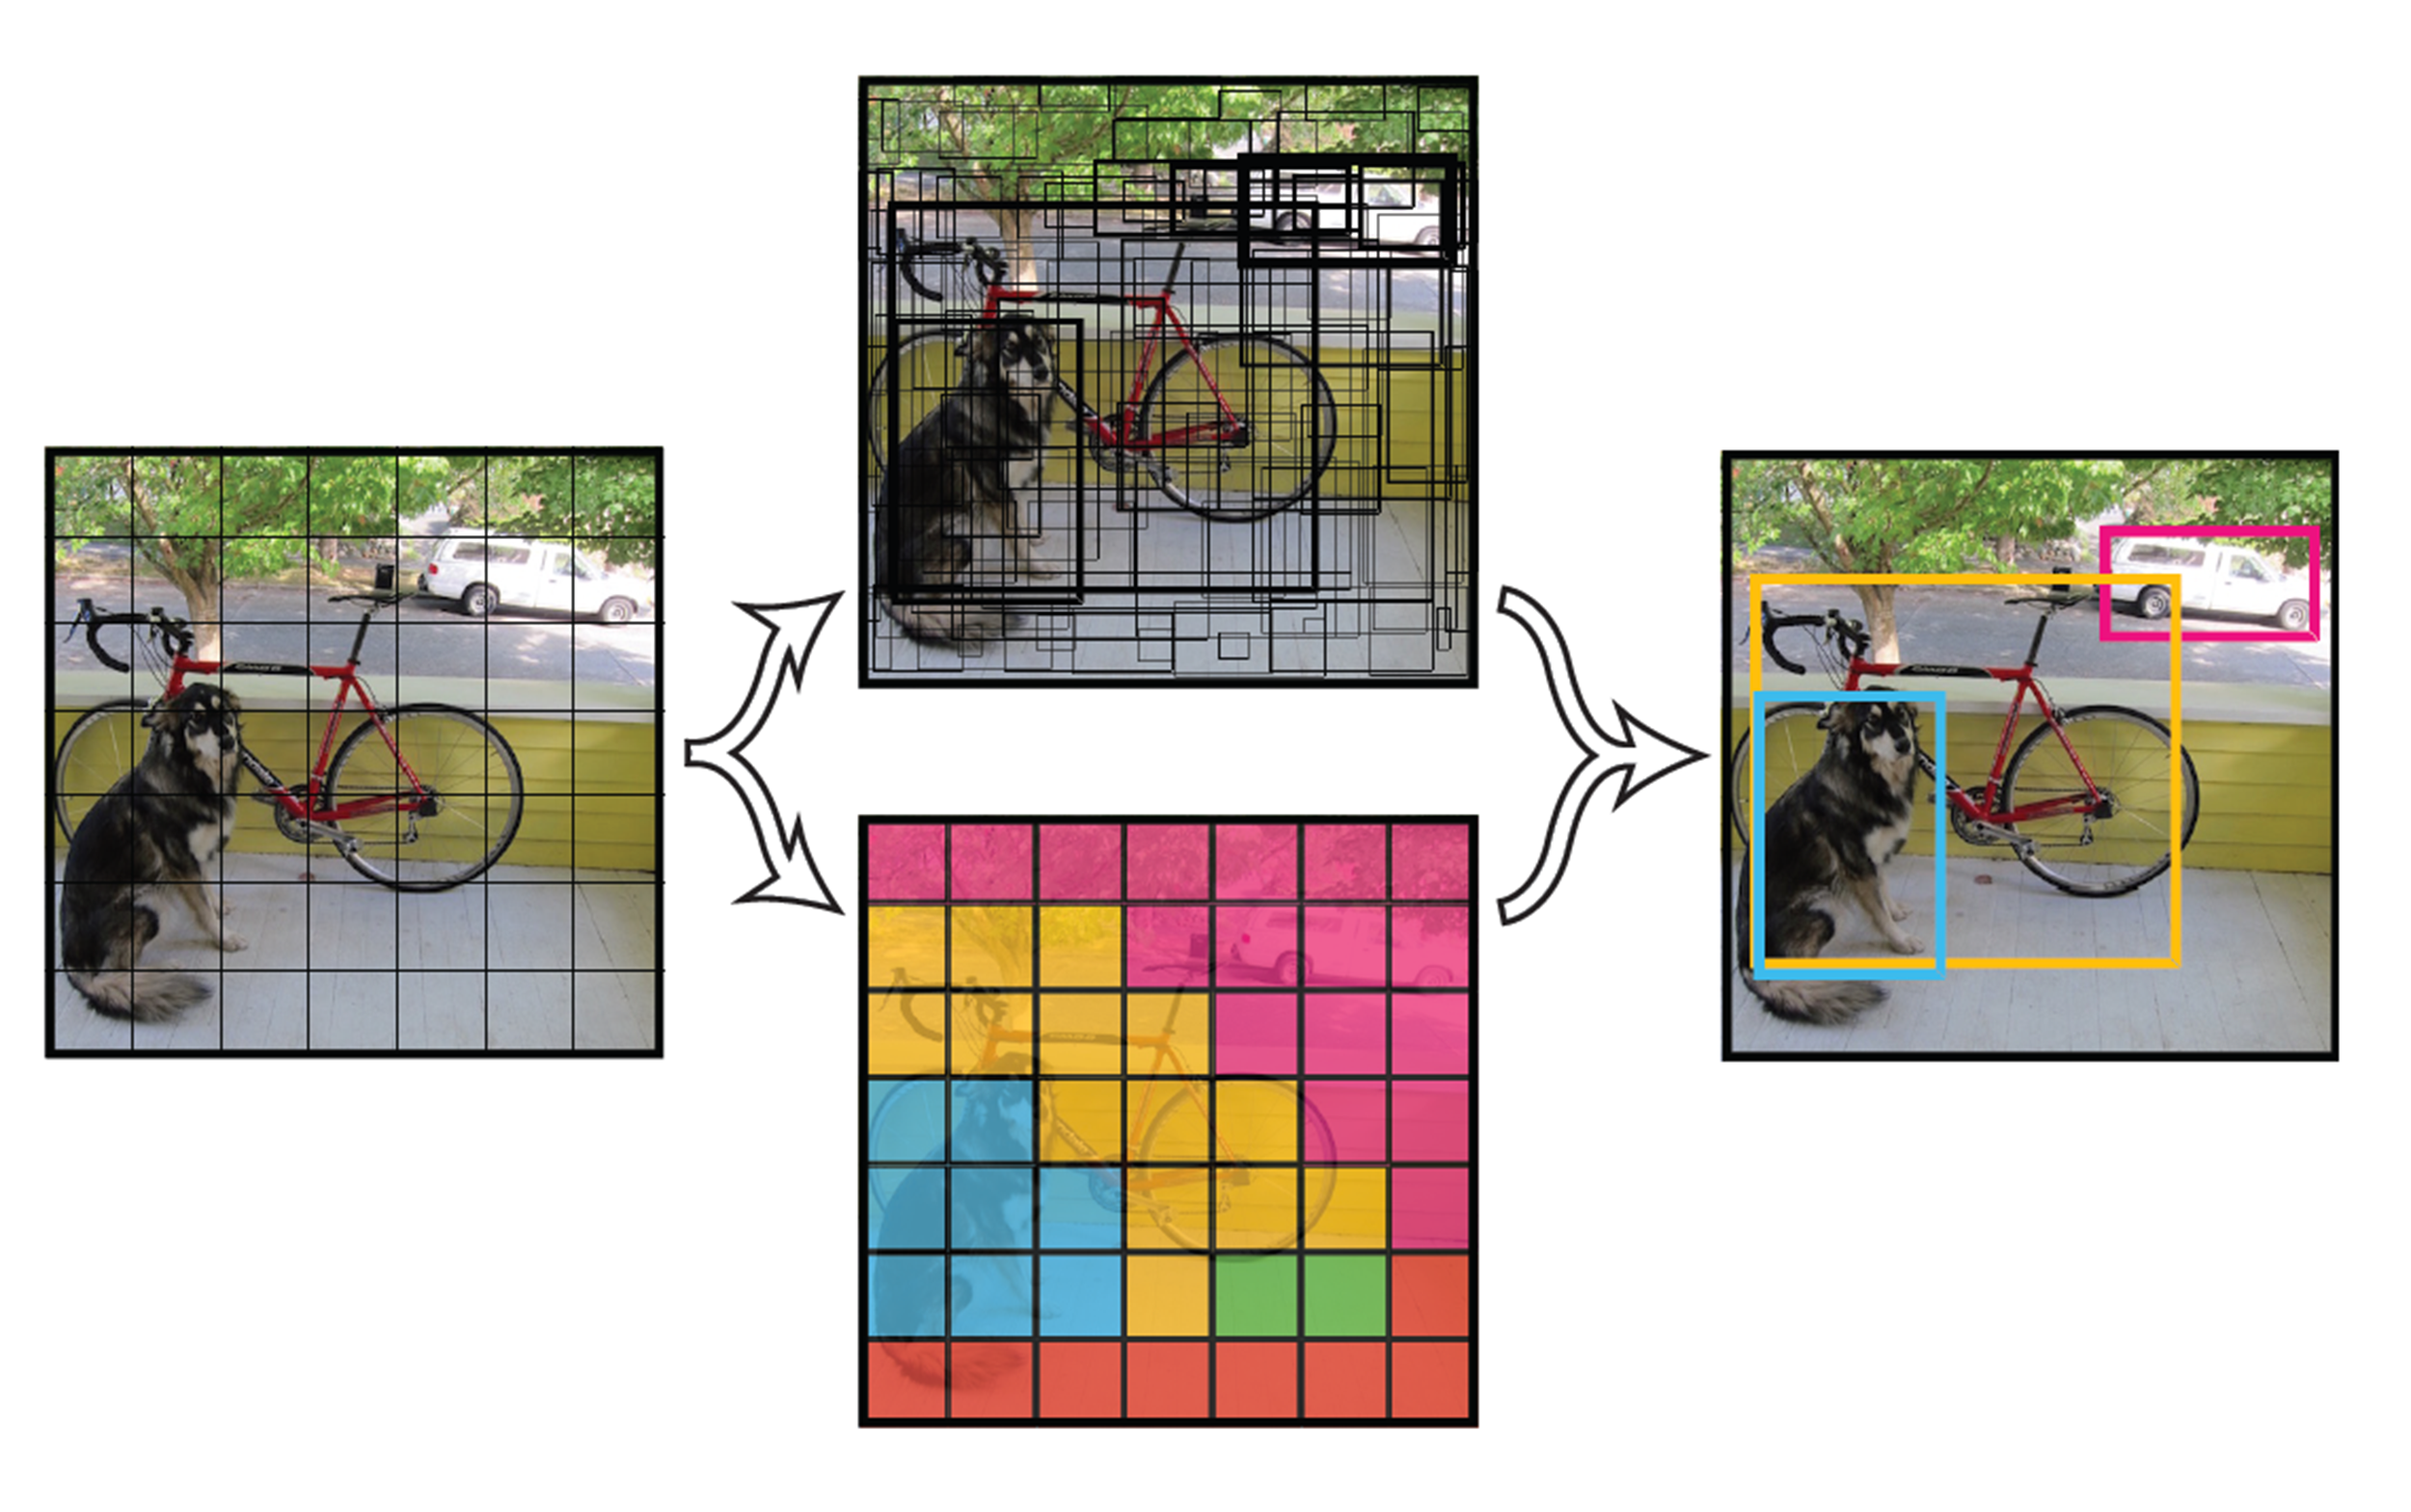
网络架构
网络结构借鉴了 GoogLeNet 。24个卷积层,2个全链接层。(用1×1 reduction layers 紧跟 3×3 convolutional layers 取代Goolenet的 inception modules )
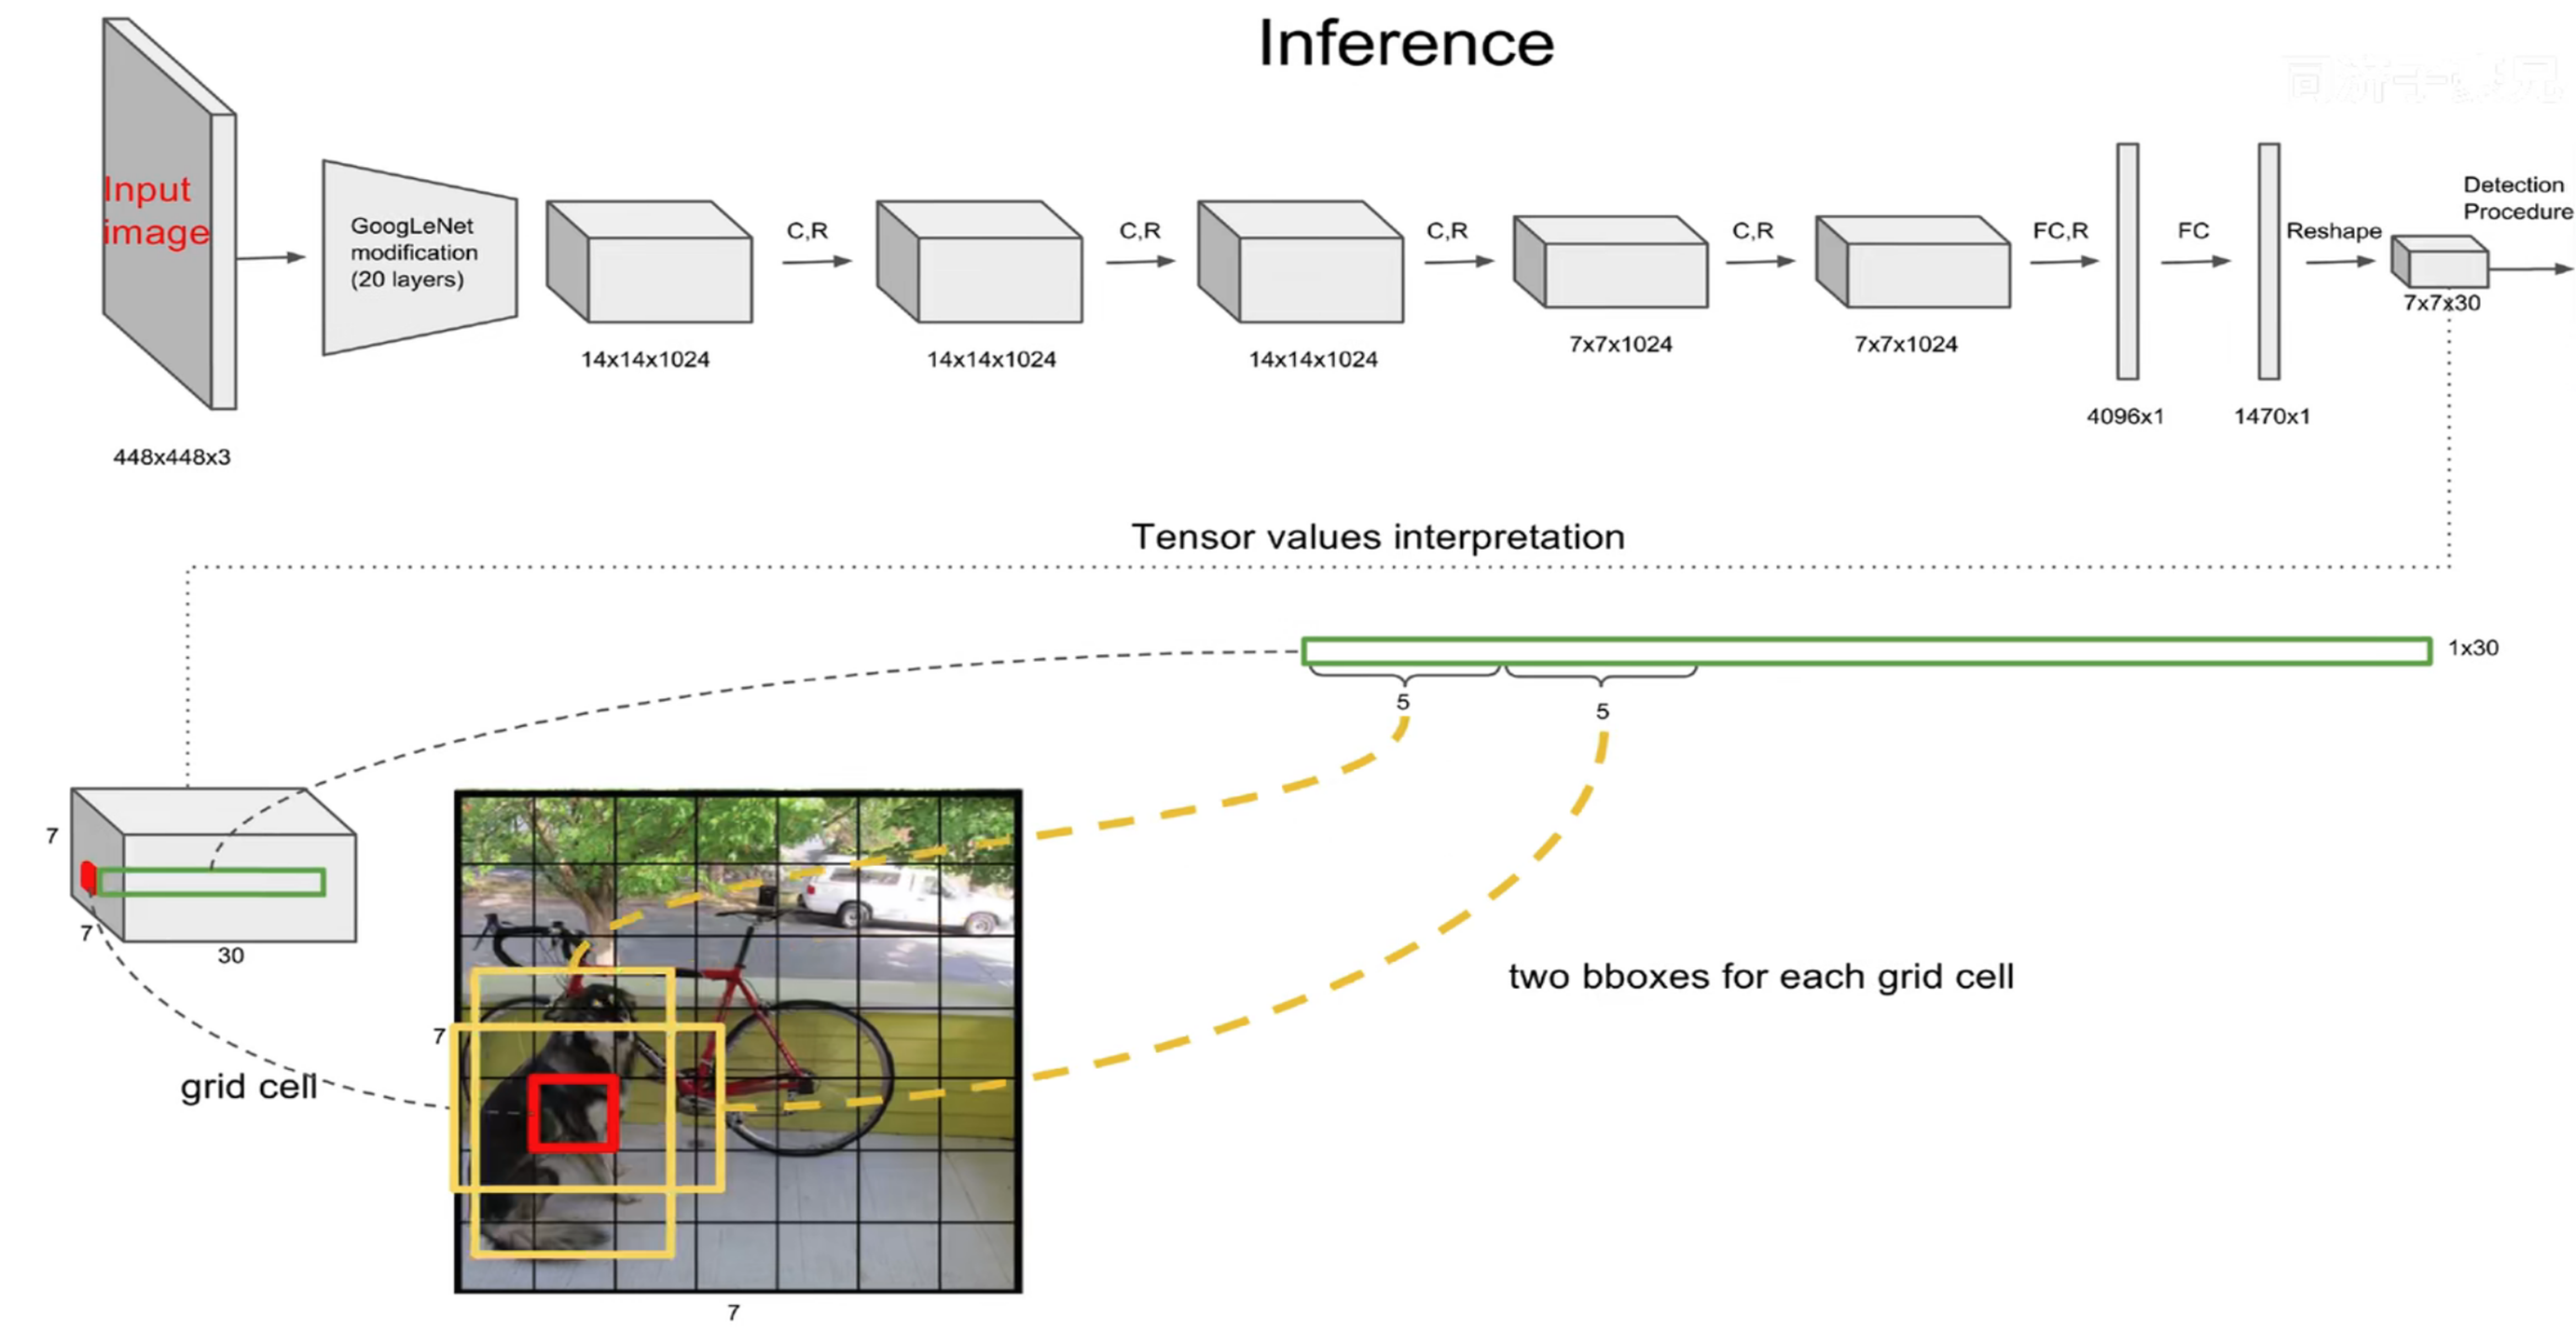
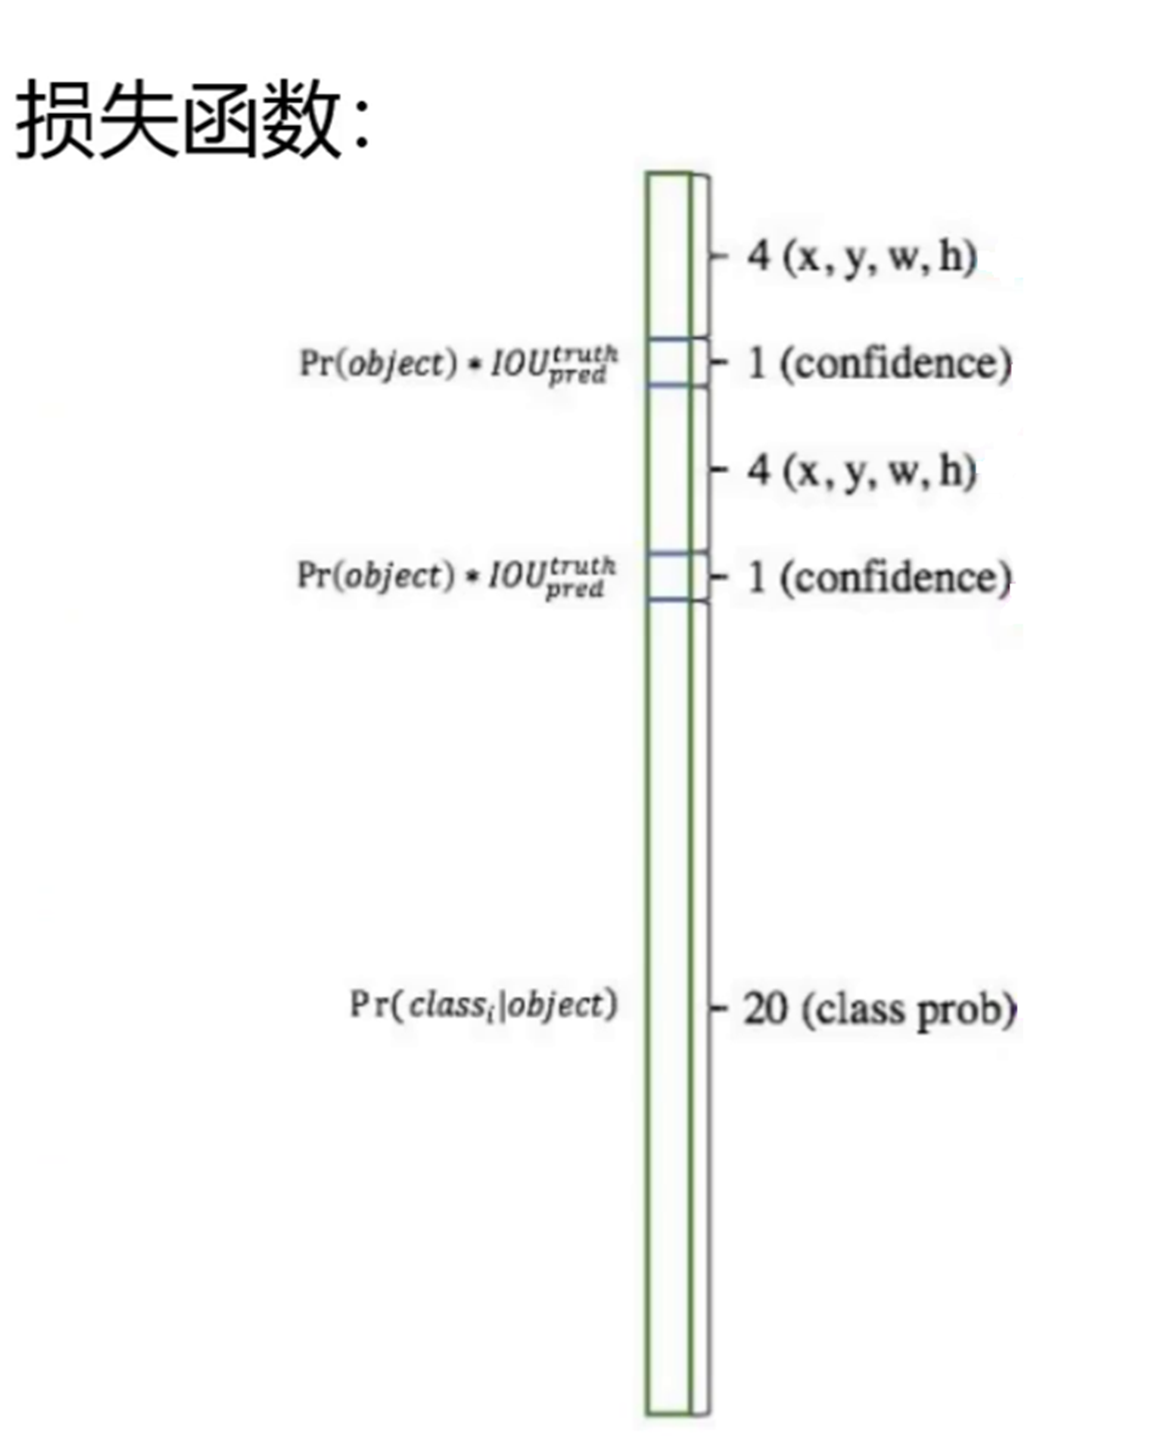
7×7意味着7×7个grid cell,30表示每个grid cell包含30个信息,其中2个预测框,每个预测框包含5个信息(x y w h c),分别为中心点位置坐标,宽高以及置信度,剩下20个是针对数据集的20个种类的预测概率(即假设该grid cell负责预测物体,那么它是某个类别的概率)。
五、 损失函数
YOLO-V1算法最后输出的检测结果为7x7x30的形式,其中30个值分别包括两个候选框的位置和有无包含物体的置信度以及网格中包含20个物体类别的概率。那么YOLO的损失就包括三部分:位置误差,confidence误差,分类误差。
损失函数的设计目标就是让坐标(x,y,w,h),confidence,classification这个三个方面达到很好的平衡。
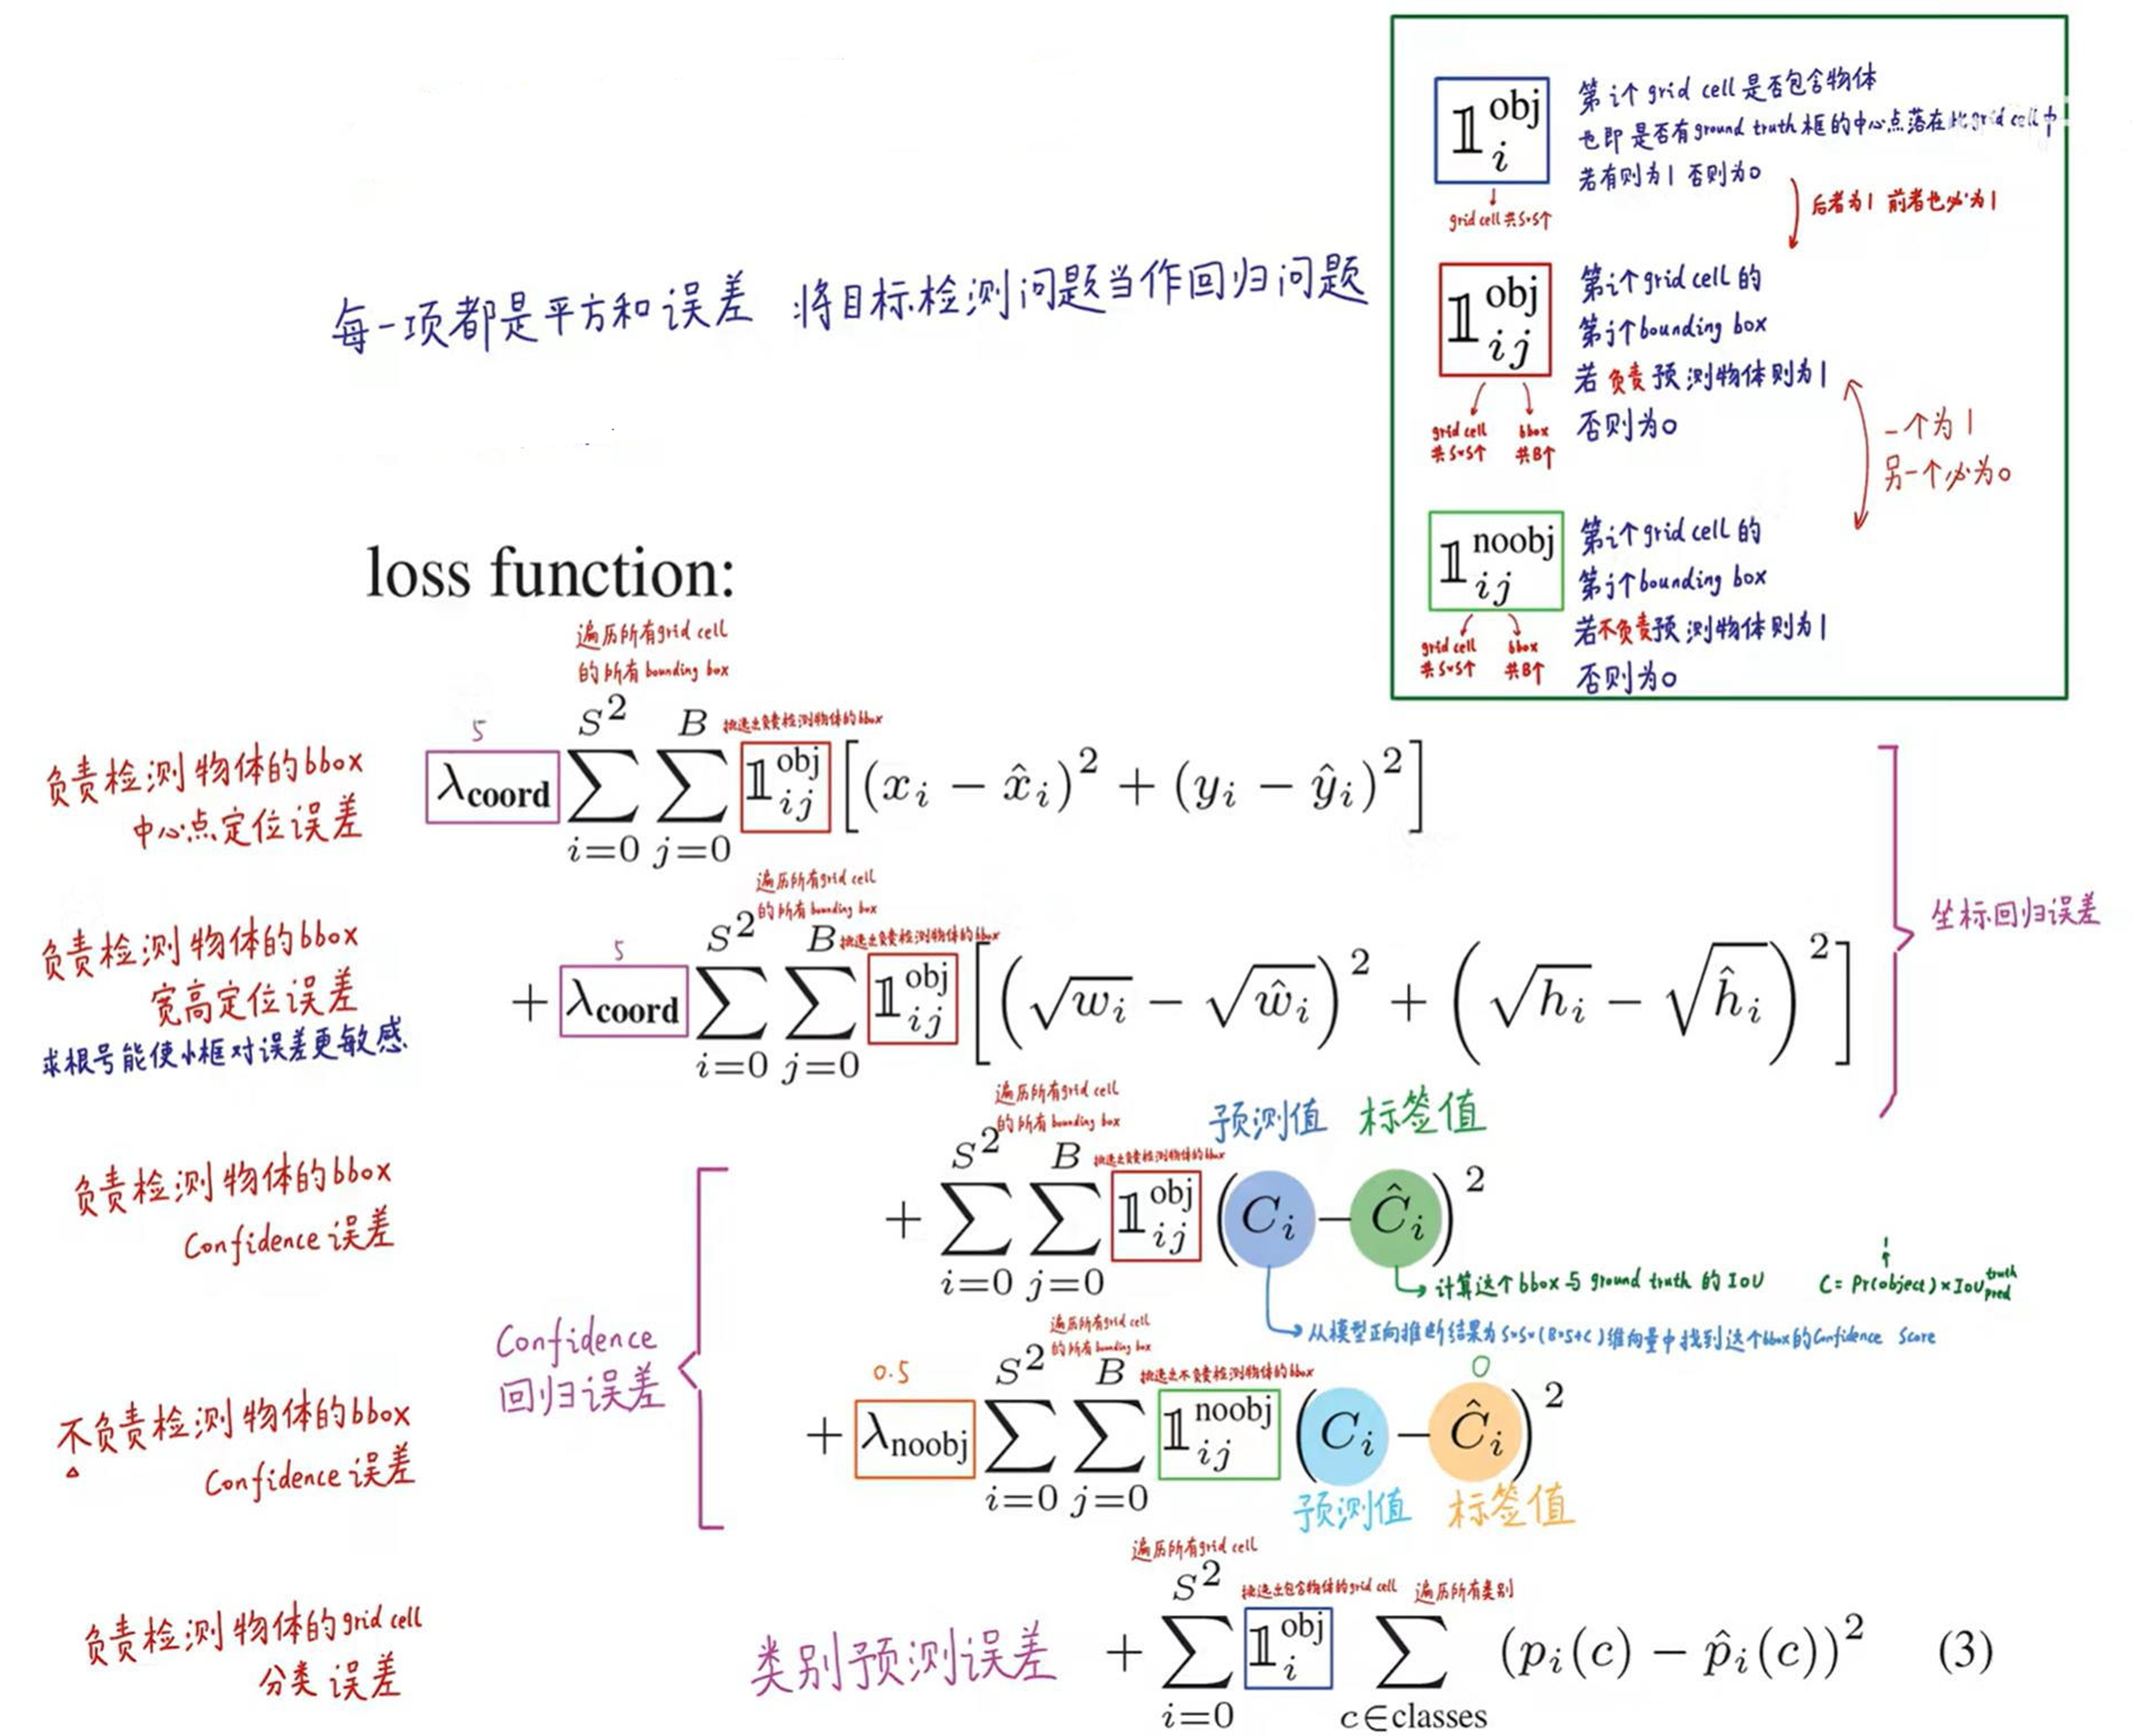
边界框回归损失:
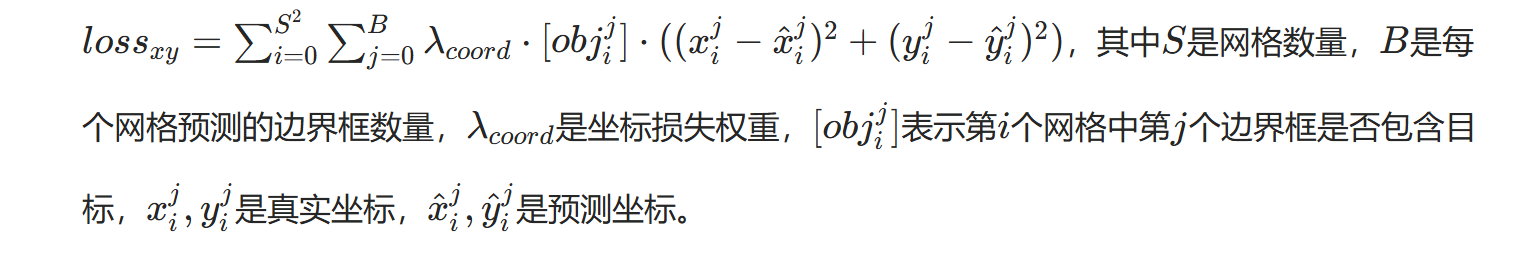
- 坐标误差:
- YOLO 通过预测边界框的中心坐标(x, y)以及宽高(w, h)来定位目标。在损失函数中,会计算预测框与真实框在坐标和宽高上的误差。例如,使用均方误差(MSE)来衡量预测框与真实框的坐标和宽高差异。
- 对于坐标(x, y),MSE 计算公式为:
宽高误差:
- 宽高误差同样使用 MSE 计算,公式为:
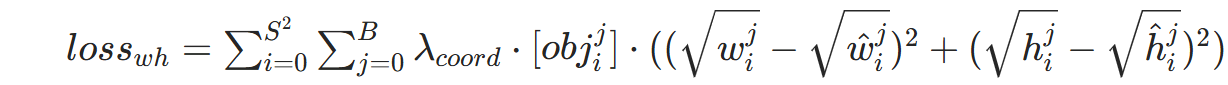
这里对宽高取平方根是为了使小目标和大目标的误差更加平衡,因为小目标的宽高误差在绝对值上可能较小,但相对误差较大。
目标置信度损失:
- 包含目标的置信度损失:
- 目标置信度表示边界框中包含目标的概率以及边界框与真实框的重叠程度(通常用交并比 IoU 衡量)。对于包含目标的边界框,使用均方误差计算置信度误差。公式为:

- 不包含目标的置信度损失:对于不包含目标的边界框,也计算置信度误差,公式为:
- 目标置信度表示边界框中包含目标的概率以及边界框与真实框的重叠程度(通常用交并比 IoU 衡量)。对于包含目标的边界框,使用均方误差计算置信度误差。公式为:
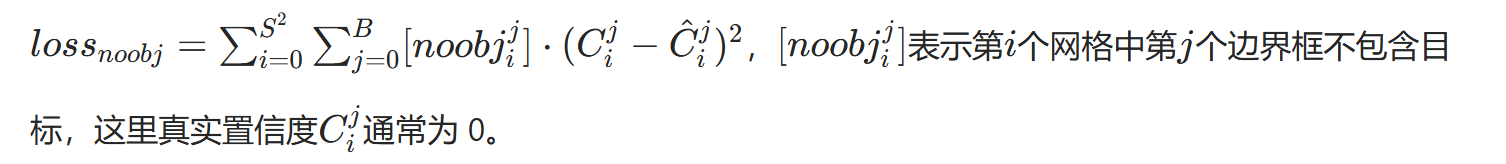
类别预测损失:
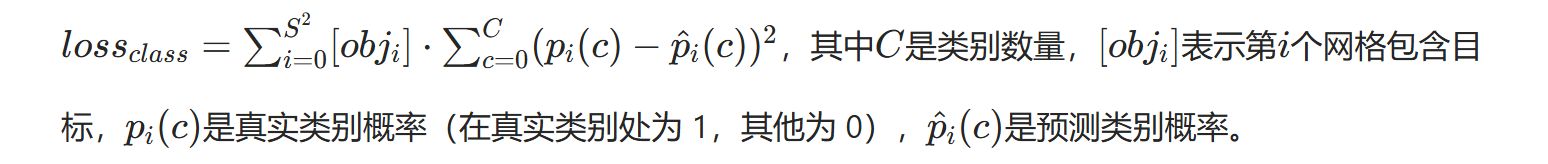
- YOLO 通过预测每个边界框的类别概率来识别目标类别。使用交叉熵损失计算类别预测误差,公式为:
整体损失函数:
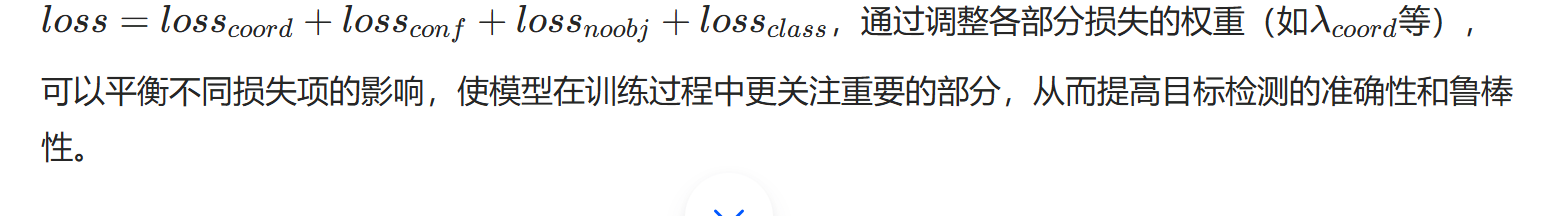
- YOLO 的整体损失函数将上述各部分损失加权求和,公式为:
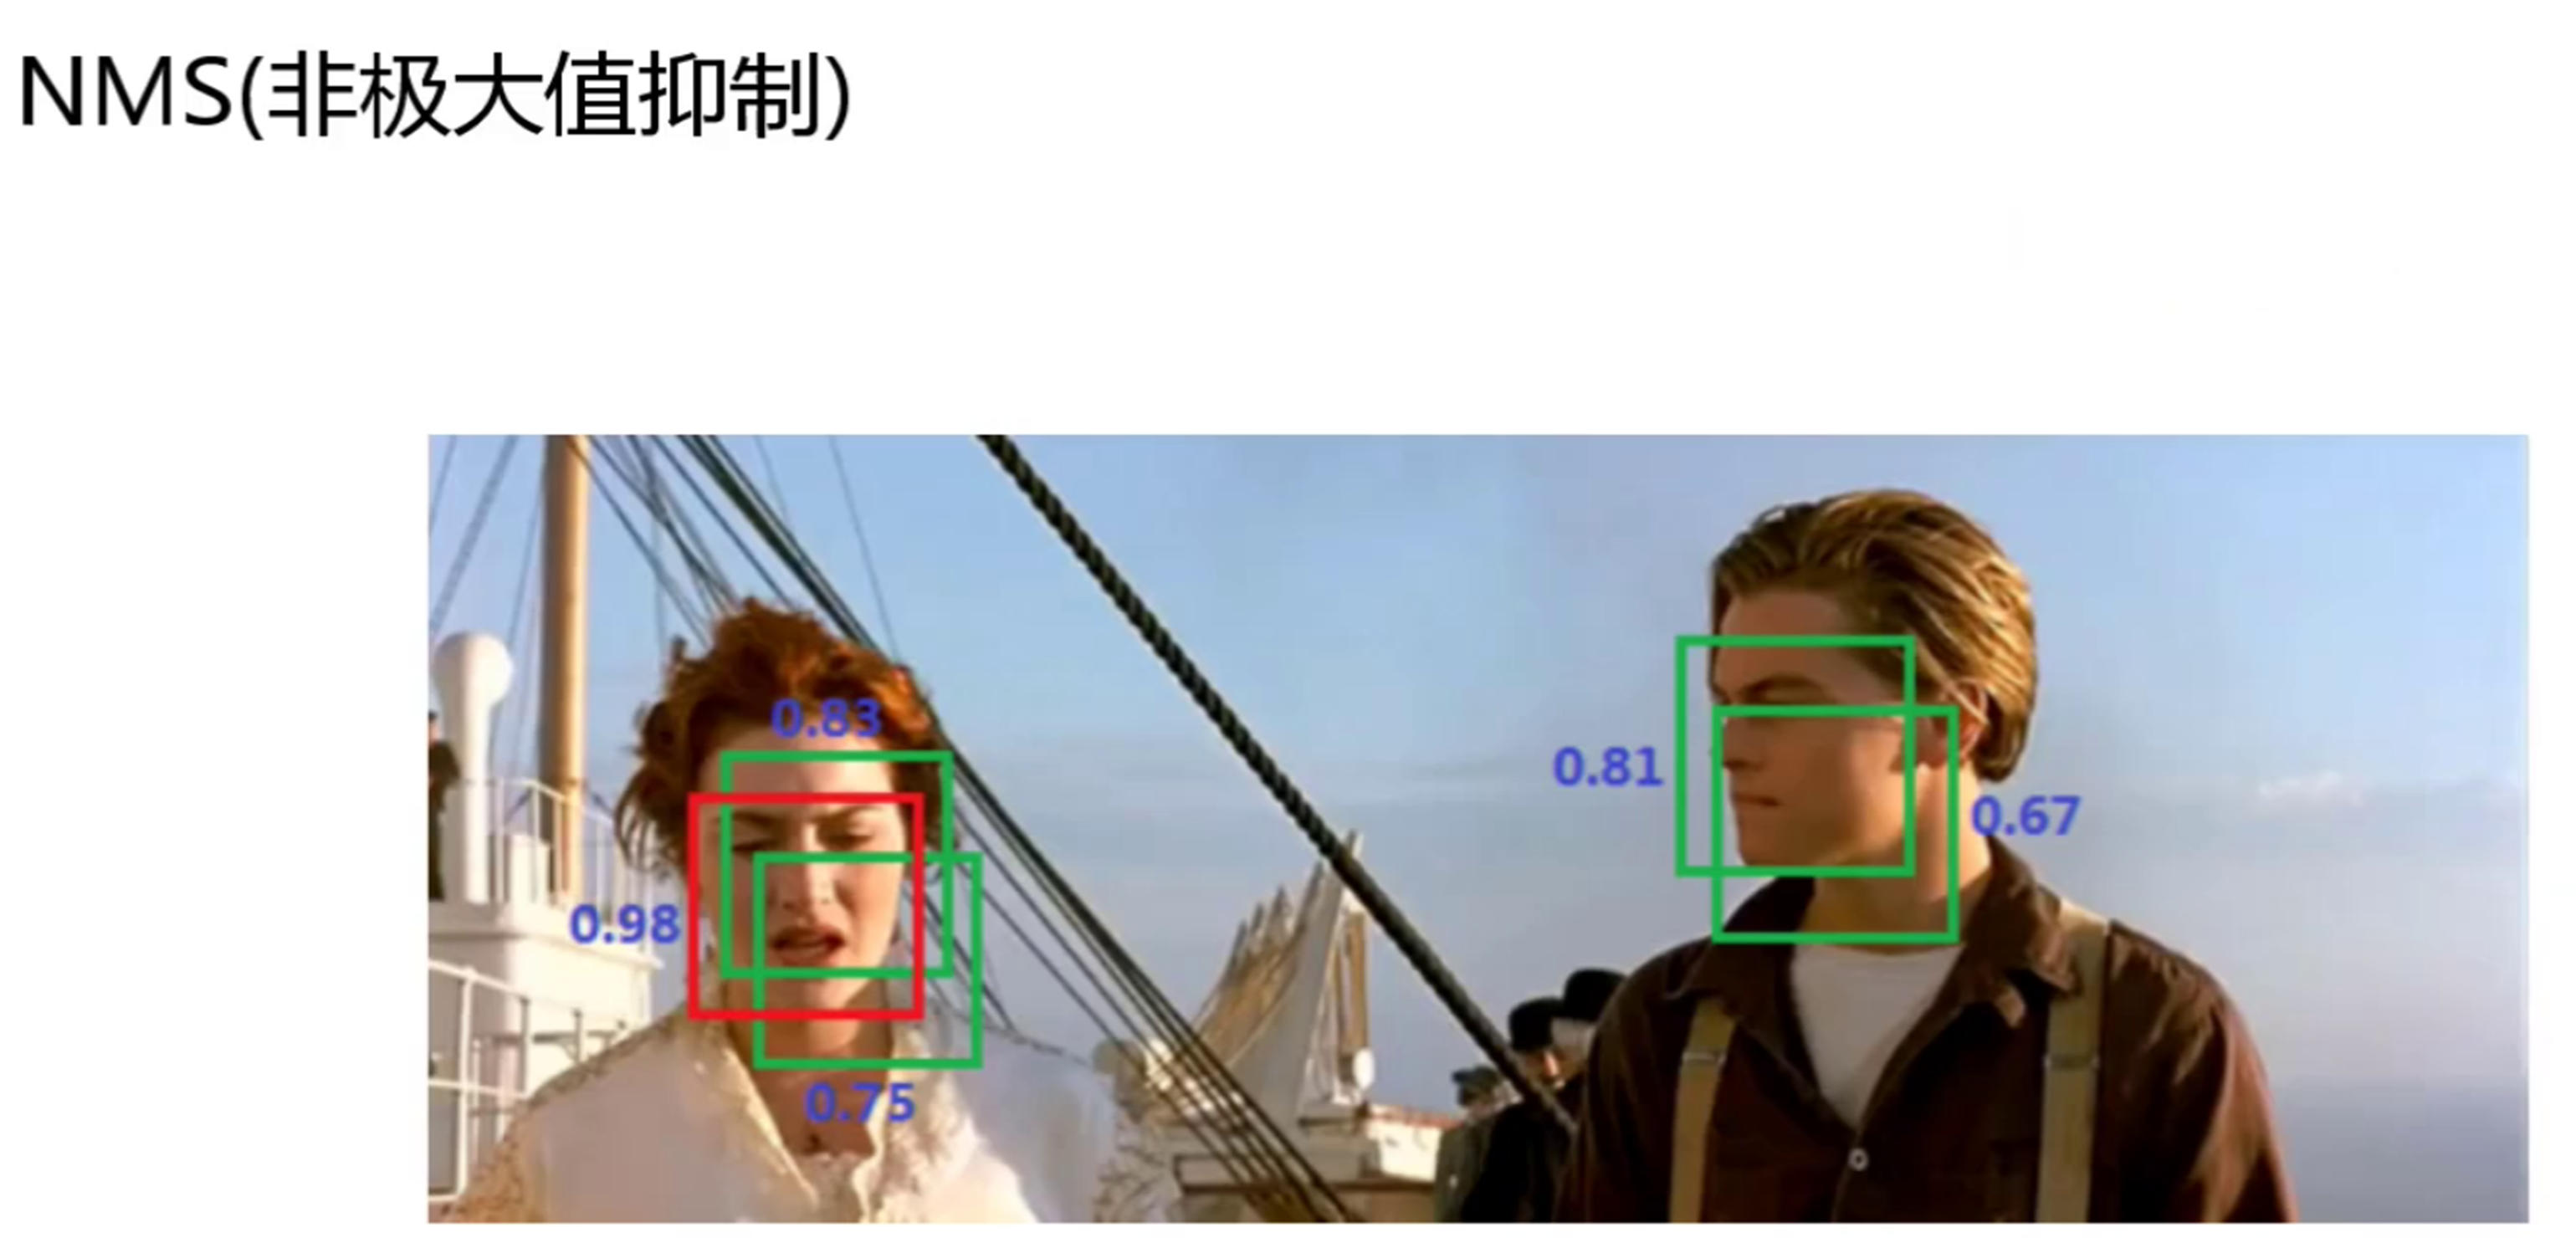
NMS:非极大值抑制(Non - Maximum Suppression,NMS)是目标检测算法中用于去除冗余检测框的关键后处理技术。
原理:目标检测算法通常会在一幅图像中生成大量的候选检测框,这些检测框可能会对同一个目标有多次重叠的检测。NMS 的基本原理是基于检测框的置信度得分和重叠程度,选择具有最高置信度的检测框,并抑制与它重叠度较高的其他检测框,只保留最具代表性的检测框,从而得到最终准确且无冗余的检测结果。
YOLO V1存在的优缺点:
优点:速度快,简单
问题1:每个cell只预测1个类别,如果重叠无法解决
问题2:小物体检测效果一般,长宽比可选,但单一。
脑启社区是一个专注类脑智能领域的开发者社区。欢迎加入社区,共建类脑智能生态。社区为开发者提供了丰富的开源类脑工具软件、类脑算法模型及数据集、类脑知识库、类脑技术培训课程以及类脑应用案例等资源。
更多推荐
 5
 0
- 0


 已为社区贡献3条内容

所有评论(0)